
월 2만 원짜리 AI 봇이 사내 질문 1,198개에 답한 건에 대하여
노션과 슬랙을 학습해 출처까지 달아 답하는 사내 AI 봇, 커피 몇 잔 값으로 만들고 운영한 눈물겨운(?) 삽질 기록.
김민재Joshua백엔드 파트 리드
🌱 0. 들어가며
입사하고 가장 많이 한 말, “이거 어디서 확인할 수 있어요?”
나 : 혹시 초대 뉴넷플릭스 정책에 대해 어디서 확인할 수 있을까요?
👩 : 노션에 있을 거예요. 근데 지난달에 또 바뀌어서... 슬랙 스레드도 같이 보셔야 해요.
나 : (노션 검색 10분째...)
피클플러스에 입사하고 얼마 안 됐을 때, 제가 가장 많이 했던 질문입니다.
피클플러스는 도메인이 꽤 복잡한 회사입니다.
저희 서비스는 외부 플랫폼과 맞물려 돌아가는 부분이 많아서, 외부 정책이 바뀌면 저희 정책도 같이 바뀝니다.
파티 매칭, 환불, 재매칭, 정산 등 여러 가지 정책에 예외 케이스가 계속 붙습니다. (지끈…)
그러다 보니 정보가 이렇게 흩어져 있었습니다.
- 정리된 정책과 기술 문서는 노션에 있습니다.
- 그 정책이 왜 바뀌었는지, 예외는 어떻게 처리했는지는 슬랙 스레드에 있습니다.
- 둘 다 계속 바뀌기 때문에, 결국 아는 사람에게 물어보는 게 제일 빨랐습니다.
새로 온 사람 입장에서는 같은 걸 묻는 게 미안했고, 답해주는 분들 입장에서는 같은 답을 반복해야 했습니다.
둘러보니 저만의 문제도 아니었습니다. 같은 질문이 여러 채널에서 계속 반복되고 있었습니다.
그래서 사내 문서를 학습해서, 슬랙에서 물어보면 출처와 함께 바로 답해주는 봇을 만들어보기로 했습니다.
이 글에서 ’학습’은 모델을 새로 훈련하는 게 아니라, 문서를 임베딩해 검색할 수 있게 저장하는 것을 말합니다.
요구사항
- 슬랙에서
@피클박사로 물어보면, 사내 문서를 근거로 답하고 출처 링크를 함께 남긴다. - 문서에 없는 내용은 지어내지 않고, “자료에서 찾을 수 없다”고 말한다.
- 운영 비용을 최대한 낮춘다.
2번은 정책을 다루는 봇이라 꼭 필요했습니다. 그럴듯하게 틀린 답을 하는 봇은 없는 것보다 위험하니까요.
또한, 최대한 저렴하게, 가능하면 거의 무료로 동작하는 봇을 만드는 것이 목표였습니다.
지금의 피클박사
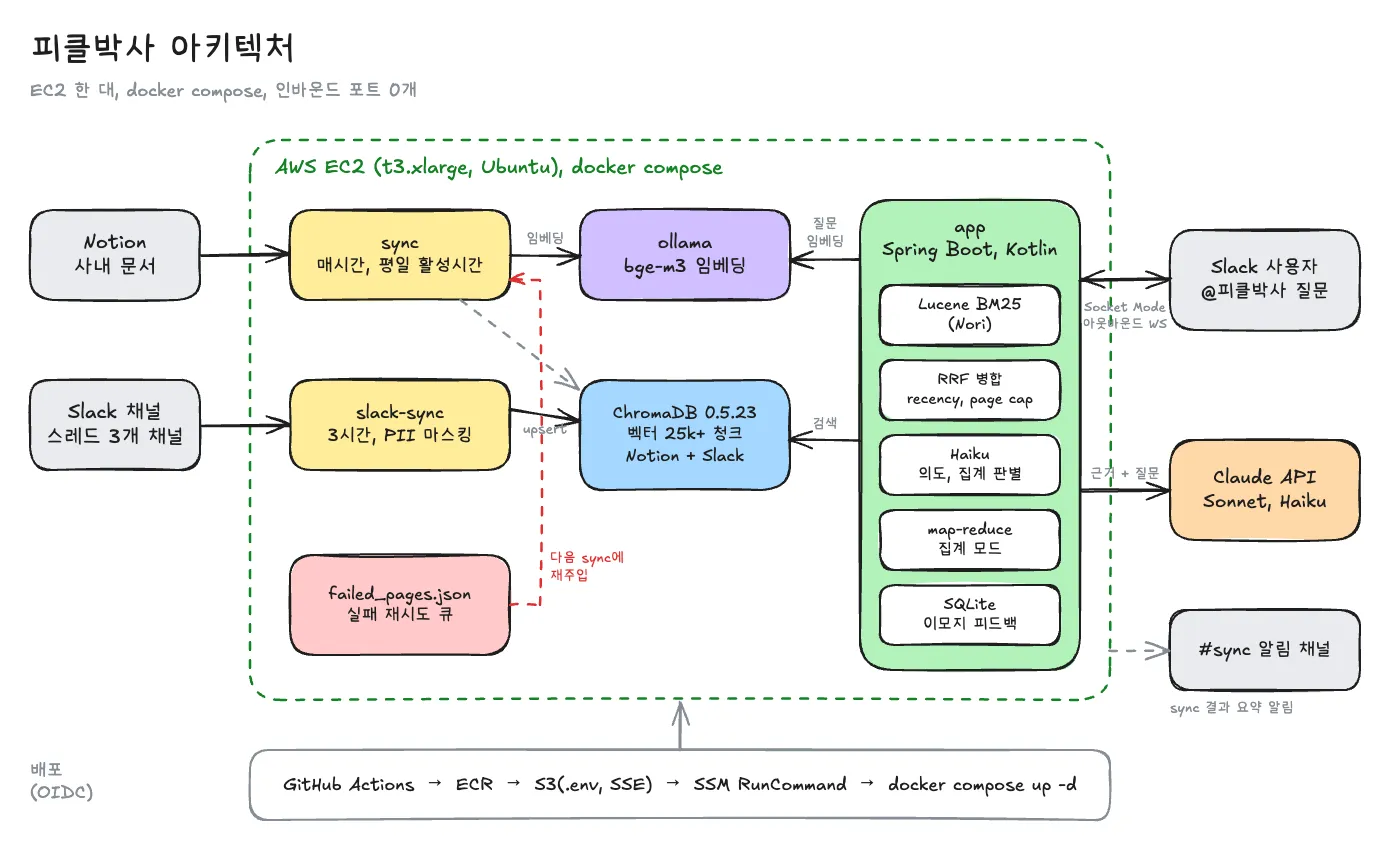
완성된 모습부터 보여드리겠습니다.
지금 피클박사는 EC2 한 대 위에서 docker compose로 컨테이너 다섯 개가 돌고 있습니다.
- app: Spring Boot + Kotlin. 슬랙 봇, 하이브리드 검색, Claude 호출, 피드백 수집
- chromadb: 벡터와 메타데이터 저장소
- ollama: bge-m3 임베딩 모델 (텍스트 → 1024차원 벡터)
- sync: 노션 → ChromaDB 증분 동기화 (매시간)
- slack-sync: 슬랙 스레드 → ChromaDB 증분 동기화 (3시간마다)
숫자로 보면 이렇습니다.
- 학습 데이터 : 노션 문서 + 슬랙 스레드, 청크 25,000개 이상
- 응답 시간 : 질문당 5~10초
- 답변 : 서버로 옮긴 뒤 3개월 반 동안 1,198건
- 유료 항목 : Claude API 와 EC2 한 대가 전부 (임베딩, 벡터 검색, 키워드 검색은 직접 띄워서 무료)
첫 커밋부터 지금까지 약 6개월! 그 사이에 했던 고민과 삽질을 순서대로 적어보겠습니다.
서론이 길었네요. 그럼 시작해보겠습니다!
💸 1. 문서를 전부 Claude 에게 주면 되지 않을까?
첫 번째 설계
처음 만든 버전은 정말 단순했습니다.
노션 문서를 전부 메모리에 올려두고, 질문이 들어오면 문서 전체와 질문을 통째로 Claude 에게 보냈습니다.
질문 → 문서 350여 개 전부 + 질문 → Claude → 답변답변 품질은 좋았습니다. 모든 문서를 다 읽고 답하니 당연한 결과였죠.
하지만 비용을 계산해보고 깜짝 놀랐습니다.
- 질문 한 번에 약 120,000 토큰
- 질문당 약 $0.72
- 하루 50건이면 한 달에 약 $1,080
이대로라면 피클플러스는 파산합니다.
게다가 문서가 조금만 더 늘어나면 Claude의 컨텍스트 윈도우(200K)를 넘어버립니다. 비용도 비용이지만, 문서가 늘어날수록 아예 동작할 수 없는 구조였습니다.
RAG 로 전환하기
그래서 RAG(Retrieval-Augmented Generation) 방식으로 바꿨습니다.
문서를 전부 주는 대신, 질문과 관련 있는 문서 조각만 찾아서 Claude 에게 전달하는 방식입니다.
질문 → 관련 문서 조각 검색 (Top 15) → 그 조각들 + 질문 → Claude → 답변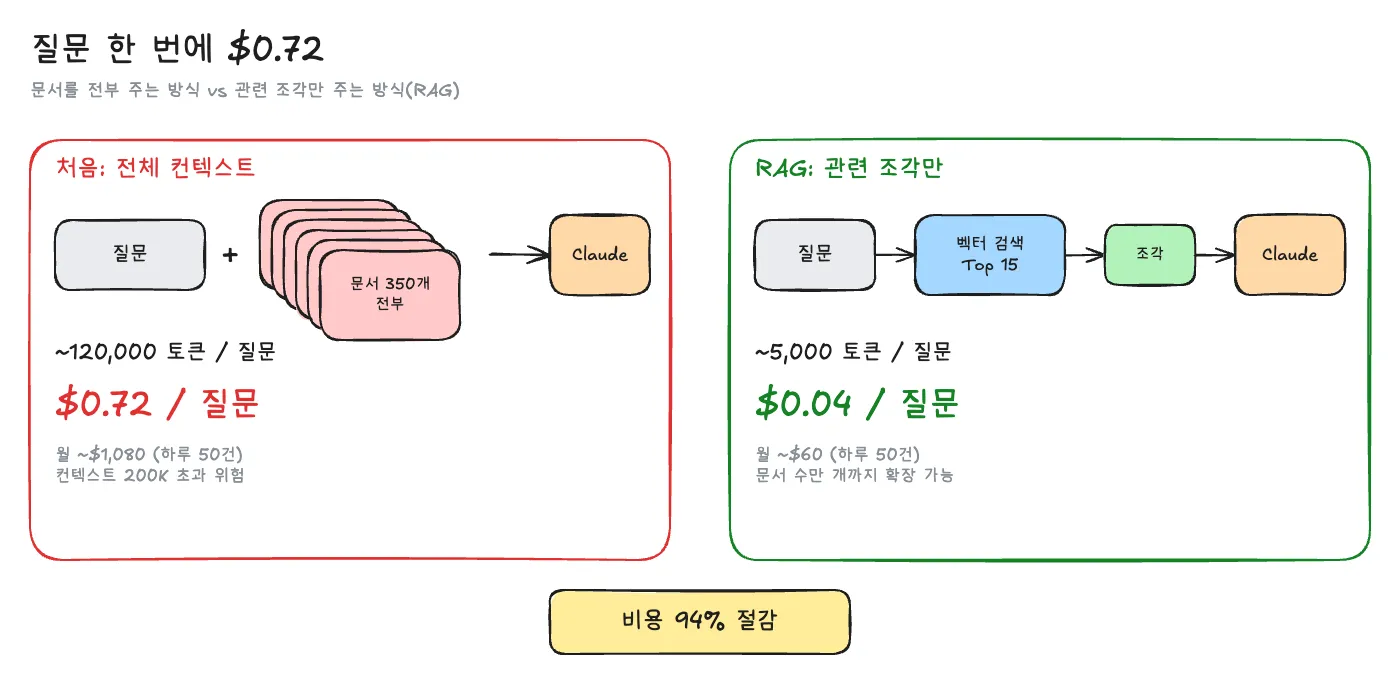
- 토큰 / 질문
- 전체 컨텍스트: ~120,000
- RAG: ~5,000
- 비용 / 질문
- 전체 컨텍스트: ~$0.72
- RAG: ~$0.04
- 월 비용 (하루 50건)
- 전체 컨텍스트: ~$1,080
- RAG: ~$60
- 확장성
- 전체 컨텍스트: 문서 수백 개가 한계
- RAG: 수만 개도 가능
RAG 를 통해 비용이 약 94% 줄었습니다.
대신 이제는 “관련 있는 조각을 어떻게 잘 찾을 것인가” 를 풀어야 했습니다.
이 문제를 어떻게 해결했는지 차근차근 살펴보겠습니다.
🔢 2. 텍스트를 숫자로 바꾸는 임베딩
임베딩이란?
컴퓨터는 “Redis 접속 방법”과 “Redis 연결 정보”가 비슷한 의미라는 걸 모릅니다. 글자가 다르면 다른 문장으로 봅니다.
그래서 텍스트를 숫자 배열(벡터) 로 바꿔서 비교합니다. 이걸 임베딩이라고 합니다.
피클박사에서는 텍스트 하나를 숫자 1,024개로 바꾸는데, 의미가 비슷한 텍스트는 비슷한 숫자 패턴이 나옵니다.
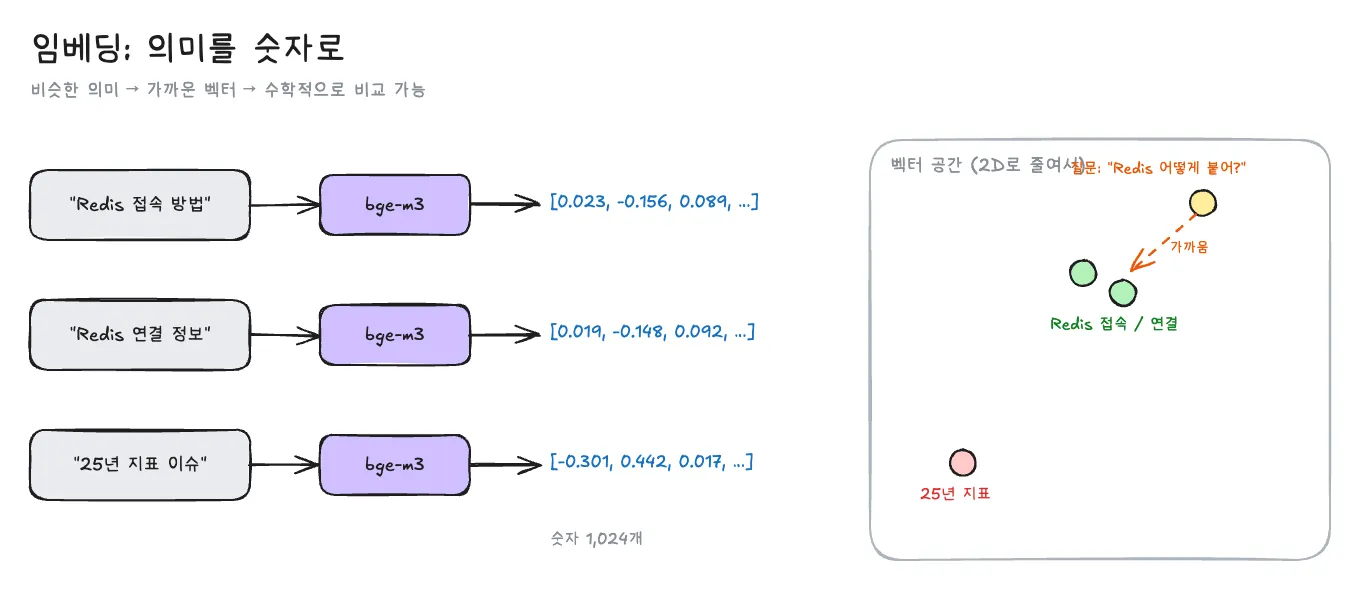
동작 방식은 이렇습니다.
- 문서를 미리 전부 벡터로 바꿔서 ChromaDB 에 저장해둡니다.
- 질문이 들어오면 질문도 벡터로 바꿉니다.
- ChromaDB 에서 질문 벡터와 가장 가까운 문서 조각들을 찾습니다.
- 찾은 조각들을 Claude 에게 전달해서 답변을 만듭니다.
각 컴포넌트의 역할을 정리하면 다음과 같습니다.
- Ollama (임베딩 모델)
- 하는 일: 텍스트를 벡터로 변환
- 비용: 무료 (서버에서 직접 실행)
- ChromaDB
- 하는 일: 벡터를 저장하고, 가까운 것을 검색
- 비용: 무료 (서버에서 직접 실행)
- Claude
- 하는 일: 찾아온 문서를 읽고 답변 작성
- 비용: 유료 (API)
임베딩을 외부 API 로 처리하면 문서를 넣을 때도, 질문을 할 때도 매번 비용이 발생합니다. 그래서 임베딩 모델은 Ollama 로 직접 띄워서 사용하기로 했습니다.
덕분에 지금도 유료로 나가는 건 답변을 만드는 Claude 호출뿐입니다. (이 비용은 대략 한 달에 $7~19 정도 나옵니다.)
공짜다 공짜! 🎉
임베딩 모델 하나 바꿨을 뿐인데
처음에는 Ollama 에서 많이 쓰는 nomic-embed-text 모델을 사용했습니다.
그런데 “25년 지표”를 검색하면 “API 명세” 문서가 나왔습니다. 몇 번을 다시 해봐도 전혀 관련 없는 문서들이 올라왔죠.
원인은 단순했습니다. 이 모델은 한국어를 잘 못했습니다.
다국어 모델인 bge-m3(BAAI) 로 교체했더니, 같은 질문에 정확한 문서가 검색되었습니다.
- nomic-embed-text
- 한국어: 부족
- 차원: 768
- 비용: 무료
- bge-m3
- 한국어: 우수
- 차원: 1024
- 비용: 무료
- OpenAI embedding
- 한국어: 우수
- 차원: 1536
- 비용: 유료
더 좋은 모델들도 있었지만 대부분 유료였고, 무료 모델 중에서는 bge-m3 의 평가가 가장 좋아서 선택했습니다.
한국어 문서로 RAG 를 만든다면, 파이프라인을 손보기 전에 임베딩 모델부터 한국어로 테스트해보세요.
💥 3. 노션 문서를 가져오다 맥북이 터질 뻔!
문서를 벡터로 만들려면 먼저 노션에서 텍스트를 가져와야 합니다. 이 동기화(sync) 작업에서 첫 번째 큰 사고가 났습니다.
JVM OOM
처음에는 동기화 로직도 Spring Boot 앱 안에서 돌렸습니다.
그런데 동기화를 돌릴 때마다 OutOfMemoryError가 발생했습니다.
메모리를 1GB 까지 올려봤는데도 똑같이 터졌습니다.
원인을 하나씩 확인해봤습니다.
- WebFlux/Reactor 의 메모리 오버헤드인가?
→ WebClient 를 RestTemplate 으로 바꾸고 WebFlux 의존성을 제거했습니다. 조금 나아졌지만 여전히 터졌습니다. - 노션 API 응답이 너무 큰가?
→ 확인해보니 페이지당 22~74KB 정도였습니다. 원인이 아니었습니다. - 텍스트를 자르는
chunk_text()함수에 무한 루프가 있었습니다.
→ 텍스트 끝에 도달하면start = end - overlap이 계속 같은 위치로 돌아오면서 조각을 끝없이 만들고 있었습니다.
메모리 사용량은 50GB 이상 까지 올라갔고, macOS 가 프로세스를 SIGKILL(137)로 종료시켰습니다.
그때 맥북이 정말 터지는 줄 알았습니다. 팬 돌아가는 소리가 꽤 무섭더라고요. 😢
무한 루프를 고친 뒤에 한 가지를 더 결정했습니다.
무거운 배치 작업과, 항상 응답해야 하는 봇을 하나의 JVM 에 같이 두지 않기로 했습니다.
그래서 동기화를 Python 으로 분리했고, 이후 sync는 약 30MB, app은 약 256MB 로 안정적으로 동작했습니다.
참고로 docker로 실행했을 때는 sync 컨테이너가 로그 한 줄 없이 137 로 종료되었습니다.
Python의 stdout 버퍼링 때문에 죽기 직전 로그가 출력되지 않았던 것인데, PYTHONUNBUFFERED=1 을 설정한 뒤에야 원인을 볼 수 있었습니다.
노션 표 안의 숫자가 사라지다
동기화가 돌기 시작하자, 이번에는 답변에서 매출 KPI 수치가 빠져 있는 걸 발견했습니다.
확인해보니 노션의 표는 table(부모) 블록 아래에 table_row(자식) 블록이 달려 있는 구조였는데, 자식 블록을 탐색하지 않고 있었습니다.
table, 토글 제목, synced_block, 컬럼 레이아웃 등에서 하위 블록을 재귀적으로 탐색하도록 수정했습니다.
같은 페이지에서 추출되는 텍스트 조각이 36개에서 124개로 늘어났습니다.
이때 노션 댓글도 같이 학습하도록 했습니다. 중요한 결정이 본문이 아니라 댓글에만 남아 있는 경우가 종종 있었거든요.
3단계 비동기 파이프라인
노션 API 는 초당 3회 정도의 요청 제한이 있고, 임베딩은 CPU를 많이 사용합니다.
문서를 하나씩 순서대로 처리하면 시간이 너무 오래 걸렸습니다.
그래서 requests 를 aiohttp 로 바꾸고, 세 단계를 큐로 연결해서 동시에 동작하도록 만들었습니다.
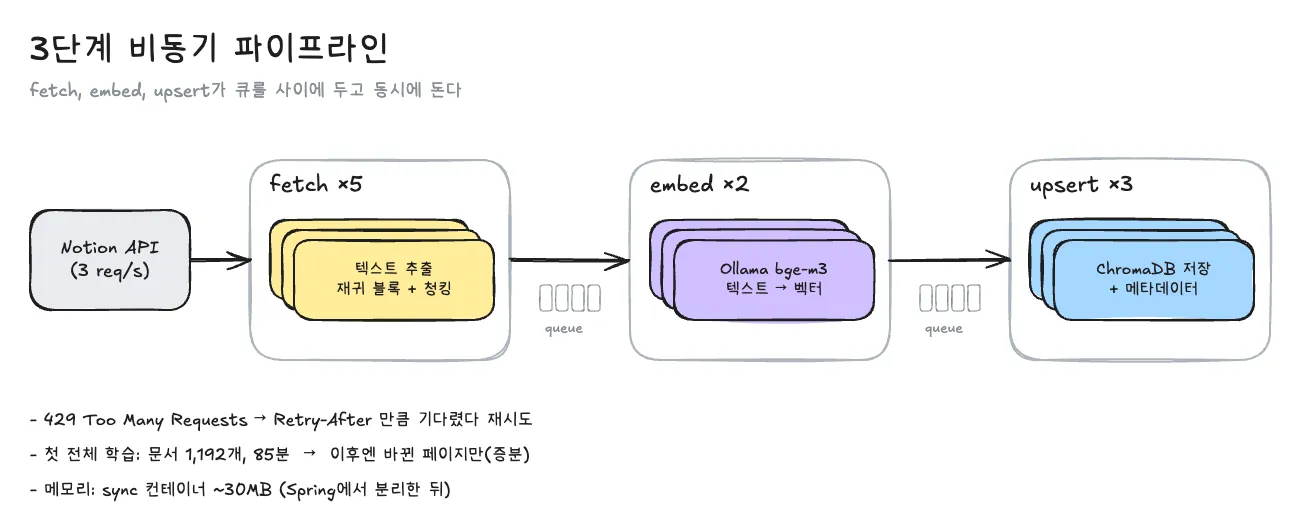
- fetch, embed, upsert 가 각각 워커를 가지고 병렬로 동작합니다.
- 429(Too Many Requests) 응답을 받으면
Retry-After헤더만큼 기다렸다가 재시도합니다.
이렇게 해도 처음 전체 문서를 학습하는 데는 1,192개 문서 기준 90분이 걸렸습니다.
그래서 두 번째 실행부터는 변경된 페이지만 다시 학습하도록 증분 동기화를 도입했습니다.
노션은 페이지마다 last_edited_time 을 제공하기에, 마지막 동기화 이후에 수정된 페이지만 처리하면 됩니다.
이때는 이걸로 충분하다고 생각했습니다.
이 last_edited_time 이 나중에 세 번이나 발목을 잡을 줄은 몰랐습니다. (7장에서 계속…)
💬 4. 슬랙에서 답하기
Socket Mode 를 선택한 이유
슬랙 봇을 연동하는 방법은 크게 두 가지가 있습니다.
- Events API : 슬랙이 우리 서버로 HTTP 요청을 보내는 방식
- Socket Mode : 우리 봇이 슬랙에 먼저 웹소켓으로 접속하는 방식
저는 Socket Mode 를 선택했습니다.
공개 URL이나 HTTPS 인증서 없이도 동작하기 때문에, 로컬 맥북에서 바로 개발하고 테스트할 수 있었습니다.
이 선택 덕분에 나중에 인프라도 훨씬 단순해졌습니다. (10장에서 이어집니다.)
같은 답변을 세 번 하는 봇
처음 연동했을 때, 피클박사는 질문 하나에 답변을 두세 번씩 했습니다. 슬랙은 이벤트가 확실히 전달되도록 같은 이벤트를 재전송하는데, 그걸 매번 새로운 질문으로 처리하고 있었던 거죠.
이벤트 ID 기반으로 중복을 걸러내도록(5분 TTL) 수정했습니다. 지금도 로그에 skipping duplication event 가 찍히는데, 정상 동작입니다.
비슷한 시기에, 질문이 한꺼번에 몰릴 때를 대비해서 요청을 큐에 넣고 순서대로 처리하도록 했습니다.
프롬프트는 영어로, 답변은 한국어로
Claude 에게 전달하는 시스템 프롬프트는 영어로 작성했습니다.
테스트해보니 영어로 작성했을 때 지시를 더 잘 따랐습니다. 답변은 항상 한국어로 하도록 명시했습니다.
핵심 규칙은 다음과 같습니다. (이해를 돕기 위해 한국어로 옮겼습니다.)
- 제공된 문서만 근거로 답할 것. 추측하거나 일반 상식으로 채우지 말 것.
- 문서에서 찾을 수 없으면: "해당 내용은 현재 정리된 자료에서 찾을 수 없습니다."
- 여러 문서가 관련되면 최신 문서를 우선 근거로 삼을 것.
- 참고한 문서는 전부 출처로 남길 것.
- 슬랙은 마크다운을 지원하지 않는다. #, **, [text](url) 금지. mrkdwn 만 쓸 것.
특히 마지막 규칙이 중요했습니다. Claude 는 습관처럼 ## 제목이나 **굵게**를 사용하는데, 슬랙에서는 이게 기호 그대로 노출되어서 답변이 지저분해집니다. 그래서 이 규칙을 가장 높은 우선순위로 명시하고, 슬랙 문법(*굵게*, <URL|텍스트>)만 사용하도록 했습니다.
비용을 조금 더 줄여보자
RAG 로 전환한 뒤에도 두 가지를 더 적용했습니다.
1. 유사도 필터링
- Top 15 를 무조건 전달하지 않고, 거리가 기준보다 먼 조각은 제외합니다. (최소 3개는 보장)
- 관련 없는 조각이 빠지면서 답변이 더 정확해졌고, 전달하는 텍스트도 약 40% 줄었습니다.
2. Prompt caching
- 시스템 프롬프트는 매 요청마다 동일합니다.
- Anthropic 의 prompt caching 을 적용해서, 캐시된 부분은 90% 할인된 가격으로 처리되도록 했습니다.
- 처음에는 TTL 을 5분으로 설정했는데, 질문 간격이 그보다 길어서 캐시가 계속 만료되었습니다. 그래서 1시간으로 늘렸습니다.
여기까지가 피클박사 V1 이었습니다.
이후, 사내에 공유하고 동료분들이 실제로 사용하기 시작하면서, 생각하지 못했던 문제들이 하나씩 드러났습니다. 어떤 문제였고 어떻게 해결했는지 이어서 살펴보겠습니다.
🔍 5. 하이브리드 검색으로 다시 만들다
벡터 검색만으로는 부족했다
실제로 사용하다 보니 벡터 검색의 약점이 보이기 시작했습니다.
- 고유명사가 묻힙니다.
“NPS”, “핫딜”, 사람 이름처럼 짧지만 중요한 단어가 문장 전체의 임베딩에 희석됩니다. 정작 그 단어가 포함된 문서가 상위에 올라오지 않았습니다. - 비슷하지만 정답은 아닌 문서가 많아집니다.
문서가 많아질수록 주제만 비슷한 문서들이 상위를 채웠습니다.
고민해보니, 벡터 검색이 약한 부분은 키워드 검색이 강한 부분이었습니다. 그래서 둘 다 쓰고 결과를 합치는 방식으로 다시 설계했습니다.
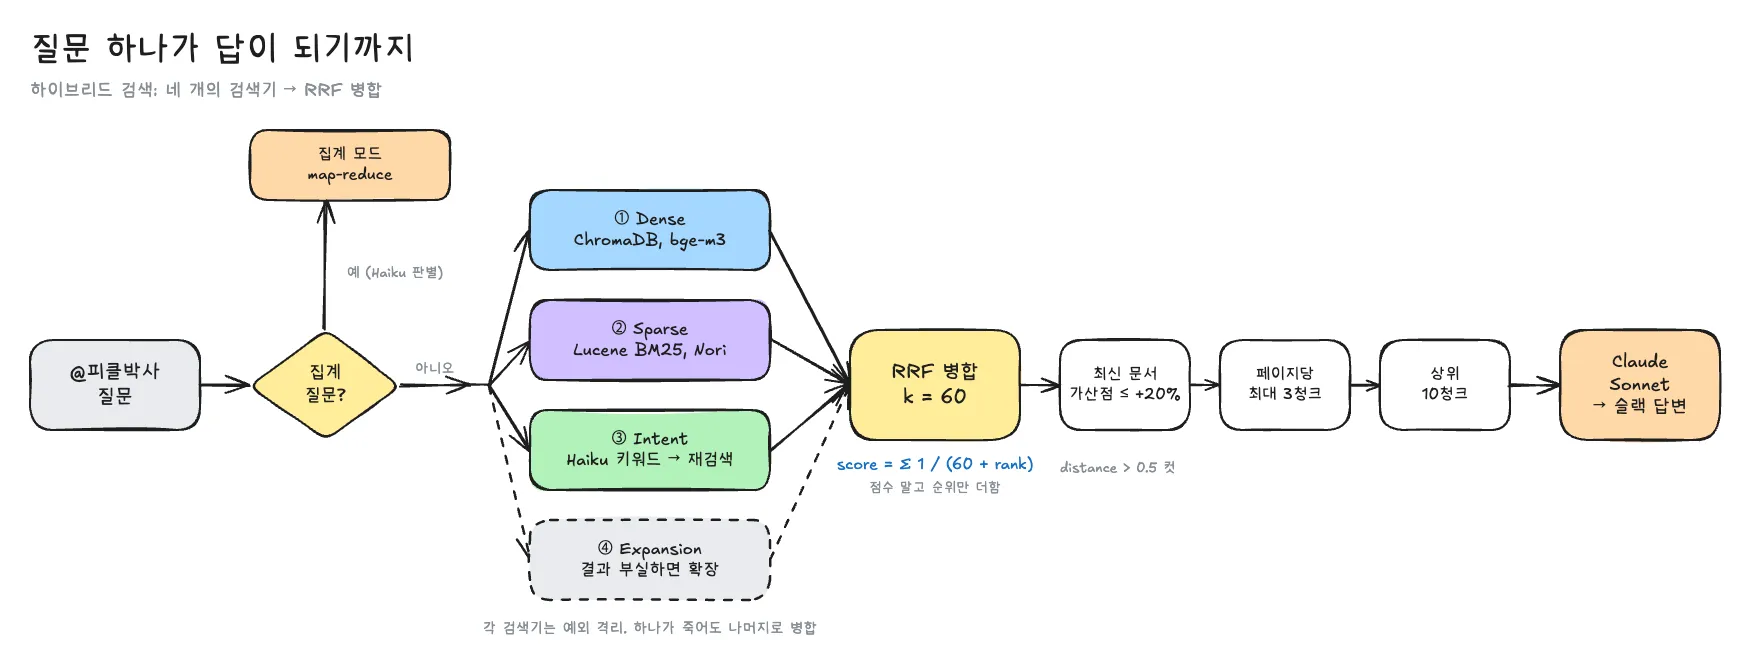
점수 대신 순위를 더하는 RRF
여기서 문제가 하나 있었습니다. 벡터 검색은 거리를 반환하고, BM25 는 점수를 반환합니다. 단위가 달라서 단순히 더할 수가 없습니다.
그래서 **RRF(Reciprocal Rank Fusion)**를 사용했습니다. RRF는 점수가 아닌 순위만 사용합니다.
score(문서) = Σ 1 / (60 + 각 검색기에서의 순위)이렇게 하면 단위 문제 없이 결과를 합칠 수 있고, 여러 검색기에서 동시에 상위에 오른 문서가 자연스럽게 위로 올라옵니다.
벡터 검색에서 1등, BM25에서 3등을 한 문서라면 믿을 만하다고 보는 겁니다.
구현하면서 신경 쓴 부분은 다음과 같습니다.
BM25 인덱스는 메모리에 둡니다.
- 앱이 시작될 때 ChromaDB 에서 전체 데이터를 읽어 Lucene 인덱스를 만들고, 60분마다 다시 만듭니다.
- 인덱스가 아직 준비되지 않았을 때 들어온 질문은 벡터 검색만으로 답합니다.
- 별도의 유료 API 는 추가하지 않았습니다.
의도 추출은 Haiku 가 담당합니다.
- “조슈아에 대해 너가 아는 거 다 알려줘” → “조슈아”
- 질문에서 불필요한 부분을 걷어내고 다시 검색합니다.
- Haiku 라서 비용은 거의 발생하지 않고, 같은 질문은 캐시로 처리합니다.
검색기 하나가 실패해도 나머지로 답합니다.
- 네 개의 검색기를 각각 예외 격리했습니다.
- 예를 들어 Haiku 호출이 실패해도, 나머지 세 검색기의 결과로 RRF 를 수행합니다.
청크가 25,000개를 넘어가면서
노션 블록을 더 깊이 탐색하고, 표와 DB까지 펼쳐서 학습하면서 청크 수가 14,000개에서 25,000개 이상으로 늘었습니다.
후보가 늘어난 만큼 노이즈도 늘어서, 검색 파라미터를 다시 조정했습니다.
- 유사도 거리 컷
- 값: 0.6 → 0.5
- 이유: 25k 규모에서는 0.6 이내에도 관련 없는 결과가 너무 많았음
- 페이지당 최대 청크
- 값: 3개
- 이유: 잘게 쪼개진 긴 페이지 하나가 상위 10개를 차지하는 것을 방지
- 최신 문서 가산점
- 값: 90일 이내, 최대 +20%
- 이유: 최신 문서를 우선하되, 원래 점수를 뒤집을 정도로 크지 않게
- JVM heap
- 값: 512m → 1g
- 이유: Lucene 이 25k 청크를 로드할 때 메모리 사용량이 급증
heap 을 넉넉하게 올린 건… 3장에서 이야기했던 OOM이 생각나서였습니다. 그 화면은 다시 보고 싶지 않았습니다.
6. RAG가 답할 수 없는 질문 (feat. MBTI 사건)
엥… 7명?
어느 날 이런 질문이 들어왔습니다.
👨 : @피클박사 10문 10답 기준으로 구성원 MBTI 분포 정리해줘
🤖 : (7명의 MBTI 를 자신 있게 정리함)
👨 : 👎👎👎 우우우~~~
구성원은 40명 가까이 되는데, 피클박사는 7명만 정리했습니다. 처음에는 버그라고 생각했는데, 확인해보니 구조적으로 답할 수 없는 질문이었습니다.
- 검색 결과는 최종적으로 10개의 청크로 추려져서 Claude에게 전달됩니다.
- 페이지당 3청크 제한도 있습니다.
- 40명의 문서를 10개의 청크에 담는 건 불가능합니다.
애초에 RAG는 질문과 가장 비슷한 문서 몇 개를 찾는 방식입니다. 특정 유형의 문서 전체를 빠짐없이 모아서 집계하는 용도로는 맞지 않았습니다.
집계 전용 경로를 만들다
그래서 집계 질문을 처리하는 경로를 별도로 만들었습니다.
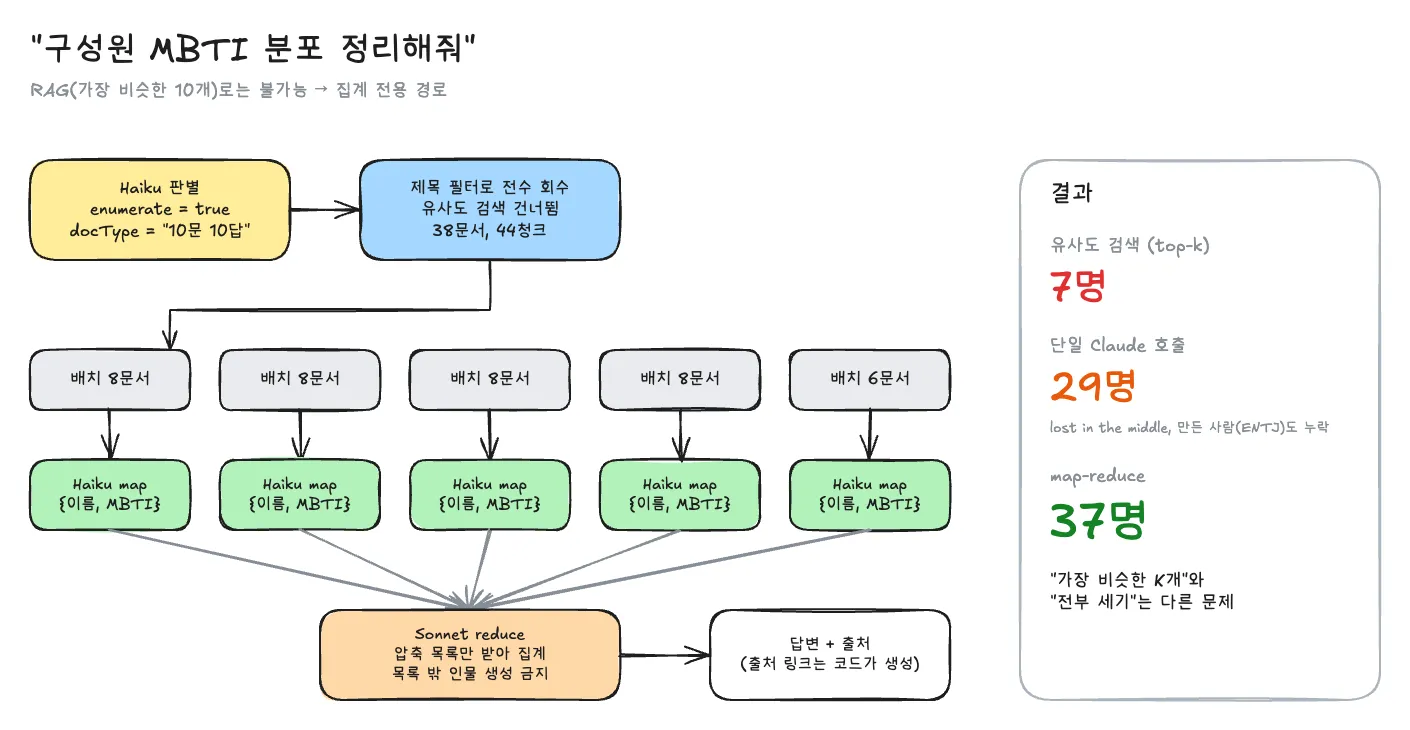
- Haiku 가 먼저 “문서 유형 전체를 집계하는 질문인지” 판단하고, 유형 이름(
10문 10답)을 추출합니다. - 유사도 검색을 건너뛰고, 제목 메타데이터 필터로 해당 유형의 문서를 전부 가져옵니다. → 38개 문서, 44개 청크
- 가져온 문서를 Claude에게 한 번에 전달해서 정리하도록 합니다.
그런데 3번에서 또 누락이 발생했습니다.
38개 문서를 모두 가져왔는데도, Claude가 한 번에 정리하면서 중간에 있는 문서 몇 개를 빠뜨렸습니다.
긴 컨텍스트의 중간 부분을 놓치는 lost in the middle 현상이었습니다.
하필 빠진 사람 중 한 명이 저(ENTJ)였습니다. 피클박사를 만든 사람인데… 조금 서운했습니다.
map-reduce 로 바꾸다
그래서 답변 생성 방식을 map-reduce 로 바꿨습니다.
map
- 문서를 8개씩 나눠서, Haiku 가 병렬로
{이름, 값}만 추출합니다.
reduce
- 압축된 목록만 Sonnet 에게 전달해서 집계하고 정리합니다.
- 목록에 없는 사람은 만들어내지 않도록 프롬프트에 명시했습니다.
출처
- LLM 이 “외 N개”처럼 출처를 뭉뚱그리지 않도록, 출처 링크 목록은 코드에서 직접 생성합니다.
한 번에 처리했을 때 29명이던 결과가 37명으로 늘었습니다. 저도 다시 ENTJ 로 돌아왔습니다. 😋
이후에는 사람뿐 아니라 회의록, 정책 등 다른 문서 유형에도 쓸 수 있도록 일반화했습니다.
💡 얻은 것
- “가장 비슷한 문서 K개를 찾는 것”과 “전체를 빠짐없이 세는 것”은 다른 문제입니다.
- 질문 유형이 다르면 경로도 따로 두어야 합니다.
🔄 7. 동기화 로직 다시 구현하기
바뀐 페이지를 찾는 데만 몇 시간
3장에서 증분 동기화를 도입했지만, 문제가 하나 남아 있었습니다.
변경된 페이지만 처리하긴 했지만, 그 페이지를 찾기 위해 매번 루트부터 블록 트리 전체를 탐색하고 있었습니다.
찾는 과정에만 몇 시간이 걸렸고, 이 상태로는 매시간 동기화를 돌릴 수 없었습니다.
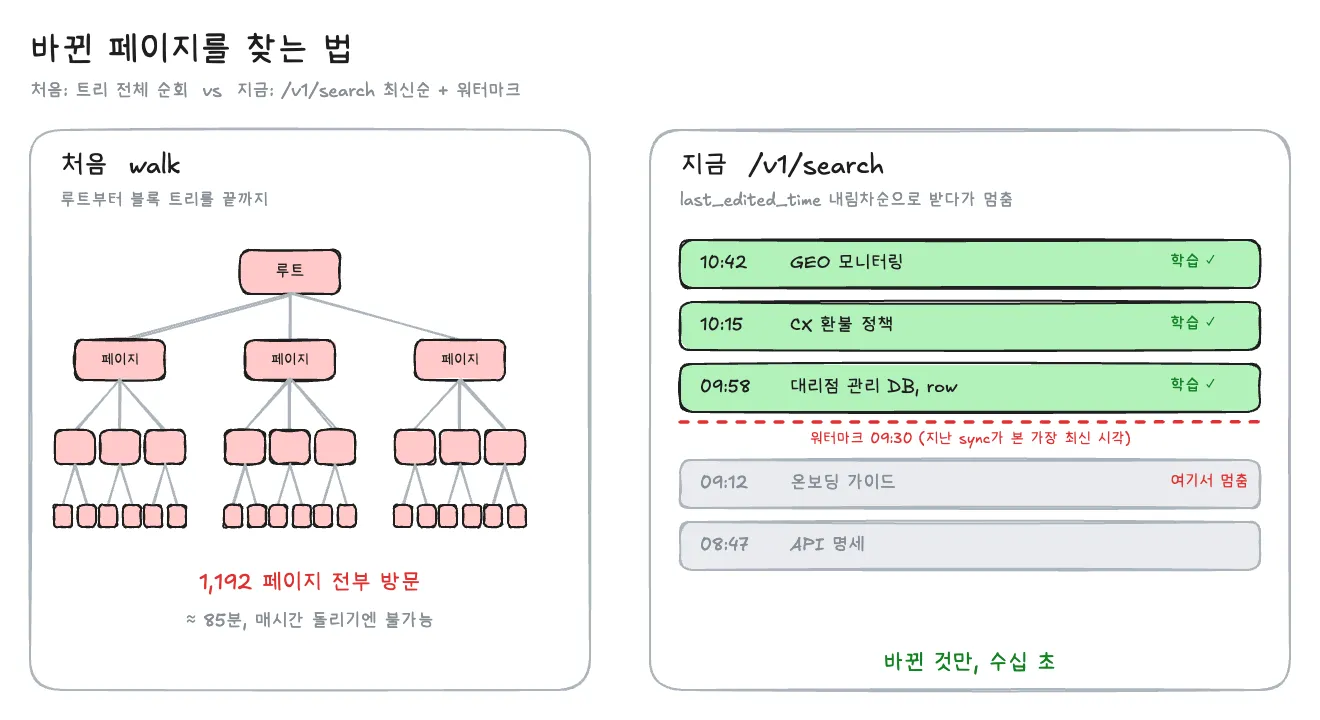
노션의 /v1/search API 는 last_edited_time 기준 내림차순으로 결과를 받을 수 있습니다. 그래서 탐색 방식을 다음과 같이 바꿨습니다.
- 지난 동기화에서 확인한 가장 최신 수정 시각을 저장해둡니다. (워터마크)
/v1/search결과를 최신순으로 확인합니다.- 워터마크보다 오래된 페이지가 나오면 탐색을 멈춥니다.
- 멈추기 전까지 확인한 페이지만 다시 학습합니다.
트리 전체를 탐색하지 않고 변경된 페이지만 바로 찾을 수 있게 되면서, 몇 시간 걸리던 탐색이 수십 초로 줄었습니다.
혹시 몰라서 DISCOVERY_MODE=search | walk | hybrid 옵션은 남겨두었습니다. 평소에는 search 로 동작하고, 전체 점검이 필요할 때만 walk 로 실행합니다.
이 과정에서 버그를 하나 더 발견했습니다. /v1/search 가 “변경된 DB”를 반환하면, 그 DB 의 모든 행을 재처리 대상에 넣고 있었습니다. 행 하나만 바뀌어도 수천 개를 다시 학습하고 있었던 거죠. 행을 조회할 때 last_edited_after 필터를 추가했더니, 변경 감지 건수가 3,701건에서 7건으로 줄었습니다.
알아서 도는 동기화
이전에는 동기화를 제가 직접 실행해야 했습니다. 제가 잊어버리면, 피클박사는 예전 정보로 답했죠. 그래서 sync 를 상주 스케줄러로 바꿨습니다.
- 평일 업무 시간대에만 매시간 실행합니다.
- 실행이 끝나면 결과를 슬랙 채널로 요약해서 보냅니다.
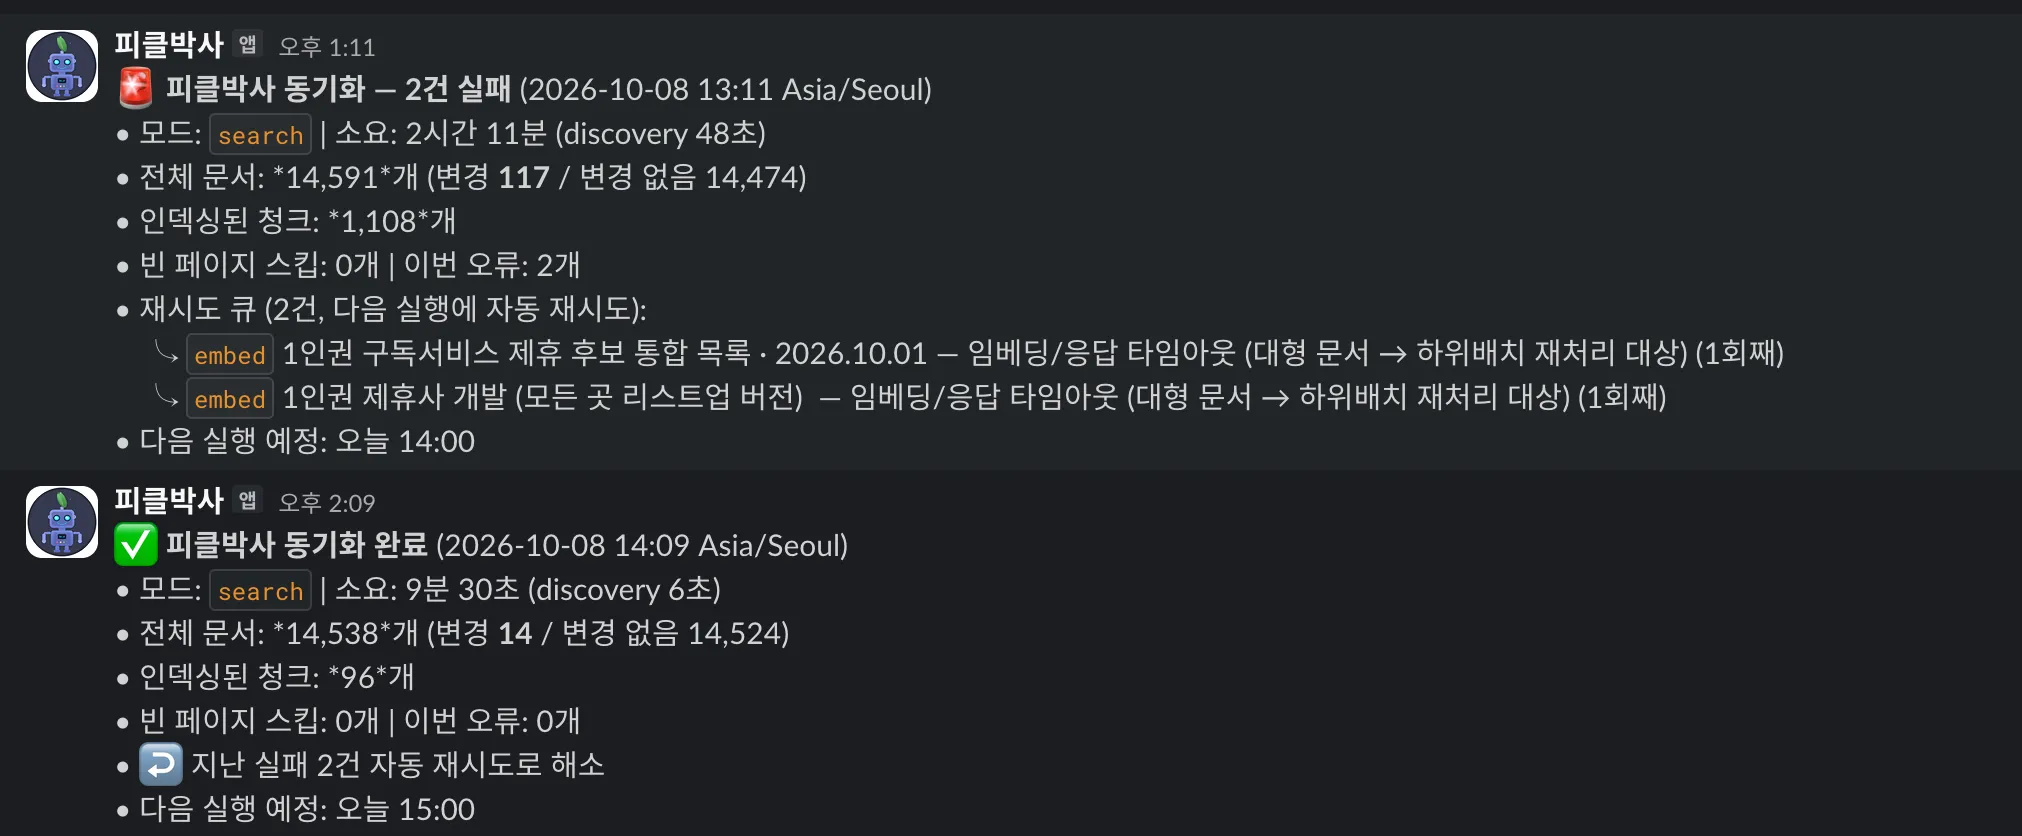
처음에는 APScheduler 의 CronTrigger를 사용했는데, 로컬 Docker Desktop 환경에서 정시 실행이 가끔 누락되었습니다.
원인을 찾아보니, Docker Desktop VM이 throttle되면 컨테이너 내부의 monotonic clock이 실제 시간보다 뒤처지고, 스케줄러가 이를 이미 지나간 실행 슬롯으로 판단해서 건너뛰고 있었습니다.
결국 스케줄러 라이브러리를 걷어내고, 30초마다 실제 시각(wall-clock)을 확인하는 단순한 루프로 바꿨습니다. 예정 시각에서 60초 이내면 실행하고, 그보다 늦은 슬롯은 건너뜁니다. 라이브러리를 빼고 while 문으로 바꿨더니 오히려 더 안정적으로 동작했습니다.
노션 last_edited_time 의 함정
이번 프로젝트에서 가장 오래 고생했던 문제 중 하나입니다. 같은 원인으로 세 번이나 문제가 발생했습니다.
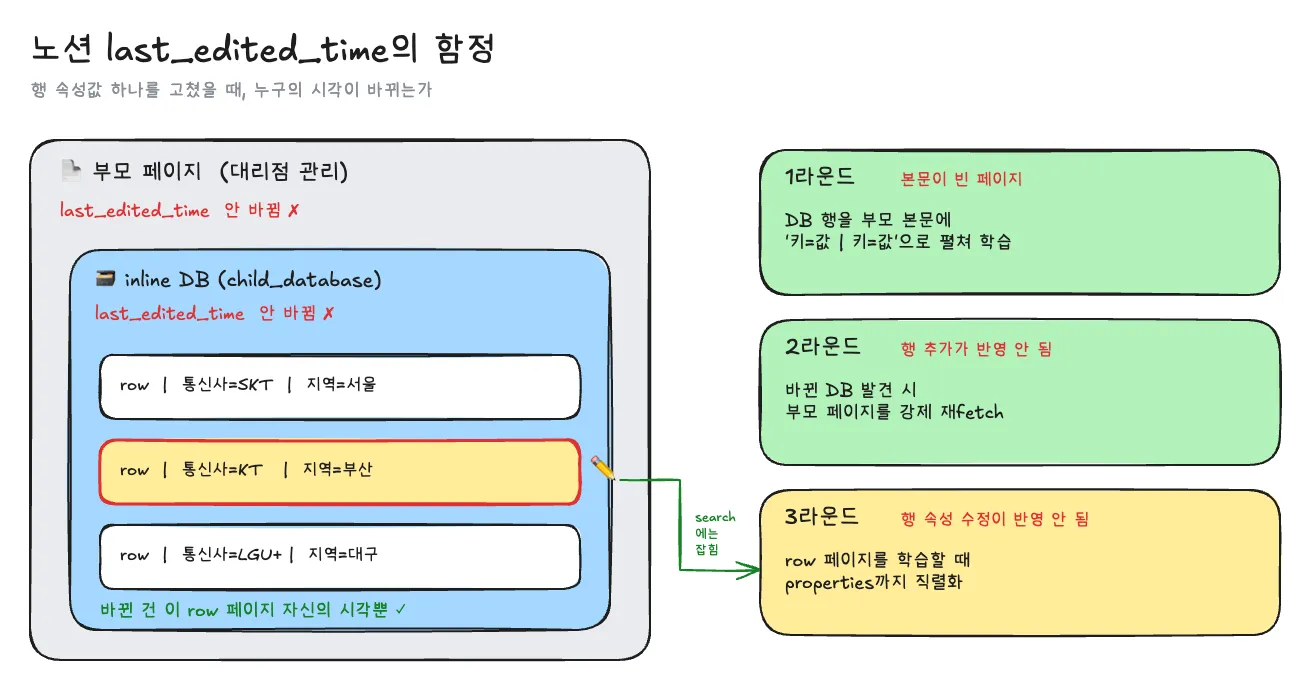
첫 번째 문제. 본문이 비어 있는 페이지
증상
- “통신사가 SKT 인 대리점 알려줘”라는 질문에 답하지 못했습니다.
원인
- 대리점 관리 페이지는 본문이 비어 있고, 정보가 모두 페이지 안의 **하위 데이터베이스(inline DB)**에 있었습니다.
- sync는 DB 블록을 건너뛰고 있었습니다.
해결
- DB의 각 행을 부모 페이지 본문에
통신사=SKT | 지역=… | …형태로 한 줄씩 펼쳐서 학습하도록 했습니다. - 청크가 중간에 잘리더라도 “열 이름=값” 쌍이 깨지지 않도록 한 줄에 담았습니다.
두 번째 문제. 행을 추가했는데 반영이 안 된다
증상
- 대리점 DB 에 새로운 행을 추가했는데, 피클박사는 계속 예전 목록으로 답했습니다.
원인
- 증분 동기화는
last_edited_time으로 변경 여부를 판단합니다. - 그런데 실제로 API를 호출해서 확인해보니, 노션은 하위 DB의 행이 바뀌어도 그 DB를 포함한 부모 페이지의
last_edited_time을 갱신하지 않았습니다. - 부모 페이지는 “변경 없음”으로 판단되었고, 펼쳐둔 DB 내용은 계속 예전 상태로 남아 있었습니다.
해결
- 변경된 DB가 발견되면, 그 DB의 부모 페이지 캐시 시각을 강제로 갱신해서 다시 가져오도록 했습니다. (추가 API 호출 없음)
- 이미 오래된 상태로 남아 있던 페이지들은 일회성 스크립트로 한 번에 다시 학습했습니다.
이 문제는 코드만 봐서는 찾을 수 없었습니다. 공식 문서에도 나와 있지 않은 동작이었습니다. 실제 API 응답을 하나씩 확인하고 나서야 원인을 알 수 있었습니다.
세 번째 문제. 행의 속성값을 수정했는데 반영이 안 된다
이제 이 문제는 모두 해결됐다고 생각했습니다. 그런데 몇 주 뒤에 이런 제보를 받았습니다.
👩 : 노션에서 '더 불러오기'로 접혀 있는 DB 내용은 피클박사가 모르는 것 같아요.
나 : 에!??!!???
증상
- DB 행의 속성값을 수정했는데, 피클박사는 계속 예전 값으로 답했습니다.
원인
- 이번에는 한 단계 더 안쪽의 문제였습니다.
- 행의 속성값을 수정하면, 부모 페이지뿐 아니라 DB 자체의
last_edited_time도 갱신되지 않았습니다. 갱신되는 건 그 행(row) 페이지 자신의 시각뿐이었습니다. - 그래서 두 번째 문제를 해결하기 위해 추가한 “DB 가 변경되면 부모 페이지를 다시 읽는다” 로직이 아예 동작하지 않았습니다.
해결
- 그나마 row 페이지 자신은
/v1/search결과에 잡혔습니다. - 그래서 DB 행 페이지를 학습할 때, 본문뿐 아니라 그 페이지의 속성(properties)까지 함께 직렬화하도록 했습니다.
- 이제 부모 페이지나 DB의 타임스탬프에 의존하지 않고, 행 하나만 수정해도 해당 행이 다시 학습됩니다.
💡 얻은 것
- 외부 서비스의 “변경 시각”은 내가 기대하는 시점에 갱신되지 않을 수 있습니다.
- 문서만 믿지 말고, 실제 API 동작으로 확인해야 합니다.
비슷한 이유로, 사용 중단 태그가 붙은 페이지를 학습에서 제외하는 기능을 추가할 때도 일회성 정리 스크립트를 따로 실행했습니다. 오래전부터 그 태그가 붙어 있던 페이지는 수정 시각이 바뀌지 않아서, 증분 동기화로는 잡히지 않았기 때문입니다.
🧵 8. 슬랙 스레드도 학습하기
실무 맥락은 슬랙에 있다
노션에는 아무래도 한 번 정제된 내용으로 문서를 저장합니다. 반면 날것의 실무 맥락은 대부분 슬랙 스레드에 남아 있습니다.
“이 케이스 예전에 어떻게 처리했었죠?“에 대한 답은 노션보다 몇 달 전 슬랙 스레드에 있는 경우가 많았습니다.
그래서 지정한 채널의 스레드를 학습하는 slack-sync 를 만들었습니다.
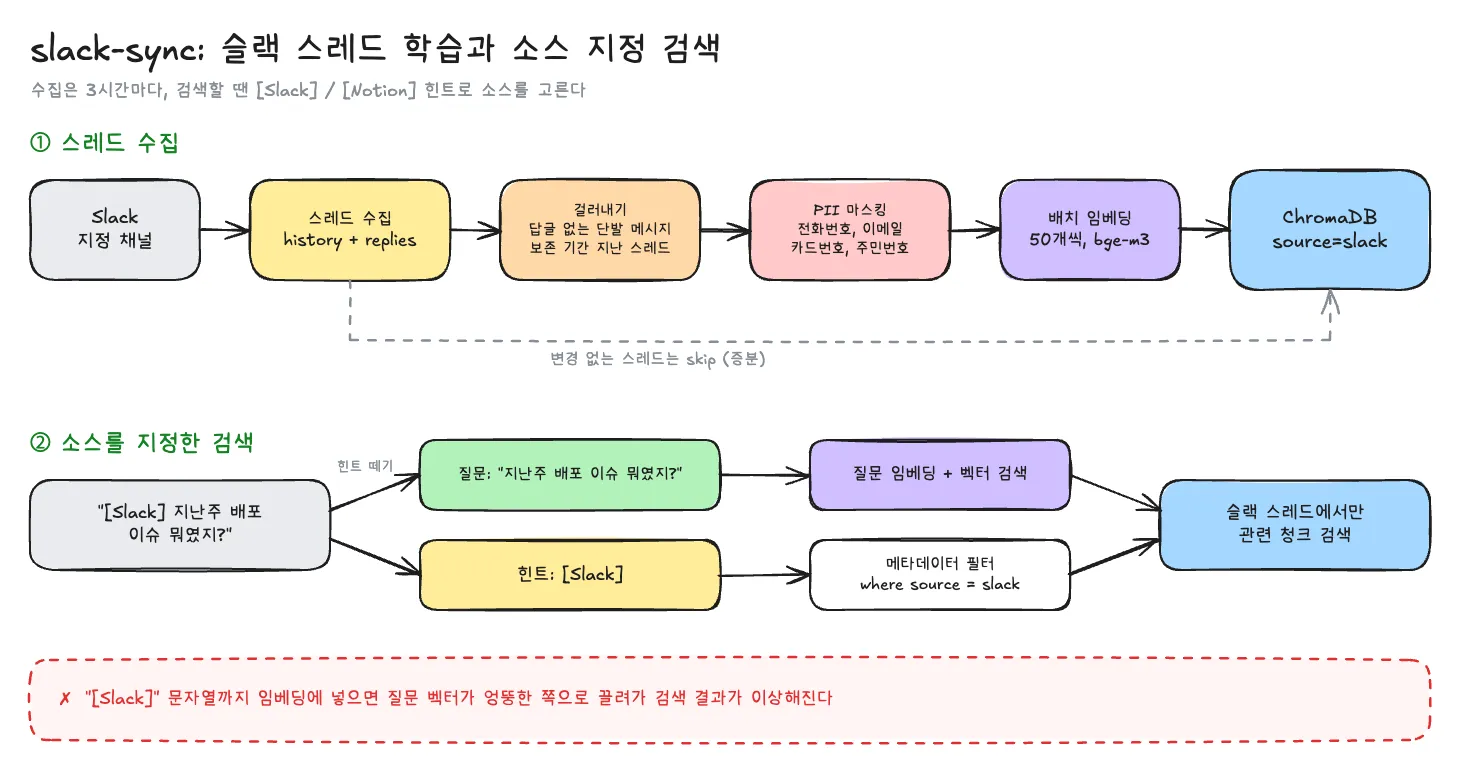
질문에 [Slack]이나 [Notion]을 붙이면 해당 소스에서만 검색하도록 했습니다. 이때 [Slack]이라는 문자열 자체가 임베딩에 섞이면 검색 결과가 이상해지기 때문에, 힌트를 제거한 질문으로 검색하고 소스는 ChromaDB 메타데이터 필터로 제한했습니다.
그런데 슬랙 스레드 학습기를 만들고 나서 몇 가지 문제가 발생했습니다.
문제 1. 답변할 때마다 팀 전체에 알림이 갔다
슬랙 원문에는 <!subteam^S04DV1DTP5X> 같은 그룹 멘션이 그대로 들어 있습니다. 이 멘션이 학습 데이터에 섞였고, 출처 링크의 제목에 포함되어 답변으로 나갔습니다. 슬랙은 이걸 실제 멘션으로 처리했습니다.
그 결과… 피클박사가 답변할 때마다 CX팀 전체에 멘션 알림이 갔습니다. 😇 (CX팀 여러분, 정말 죄송했습니다.)
두 단계에서 막도록 수정했습니다.
- 학습 단계 : 그룹/전체 멘션을
@이름으로 바꾸거나 제거합니다. - 송신 단계 : 슬랙으로 보내기 직전에 한 번 더 걸러냅니다. 이미 학습된 데이터도 다시 학습할 필요 없이 바로 차단됩니다.
한쪽에서 새로운 멘션 패턴을 놓치더라도 다른 쪽에서 잡을 수 있도록 일부러 두 군데에 두었습니다.
같은 송신 필터에서 노션 링크의 app.notion.so 도 www.notion.so 로 바꿔줍니다. app. 링크는 로그인된 노션 앱 전용 주소라서, 슬랙에서 클릭하면 로그인 페이지로 이동하는 문제가 있었습니다.
문제 2. 노션 sync가 슬랙 데이터를 노션 페이지로 착각하다
노션과 슬랙 데이터를 같은 ChromaDB 컬렉션에 저장했습니다. 그랬더니 노션 sync가 기존 청크 목록을 읽으면서, 슬랙 청크의 ID(1762300990.754789 같은 thread_ts)를 노션 페이지 ID로 착각하고 노션 API를 호출했습니다.
노션은 당연히 “올바른 UUID가 아니다”라며 400 에러를 반환했습니다. 슬랙 청크 562개에 대해 각각 2~3번씩 호출하고 있었죠. 데이터에는 문제가 없었지만, 로그가 에러로 가득 찼습니다.
노션 sync가 조회할 때 source가 노션인 데이터만 가져오도록 필터를 추가해서 해결했습니다.
한 컬렉션에 여러 소스를 넣을 계획이라면, 처음부터 모든 조회에 소스 조건을 넣어두세요. 나중에 넣으면 이런 문제가 생깁니다.
📊 9. 답변 품질을 숫자로 확인하기
이모지 반응을 수집하다
사실 6장에서 언급했던 MBTI 답변에 달린 👎👎👎 이모지는 제가 우연히 본 것이었습니다. 그 스레드를 보지 못했다면 문제가 있다는 것도 몰랐을 겁니다. 이걸 계기로 피클박사 답변에 달리는 이모지 반응을 모두 수집하기로 했습니다.
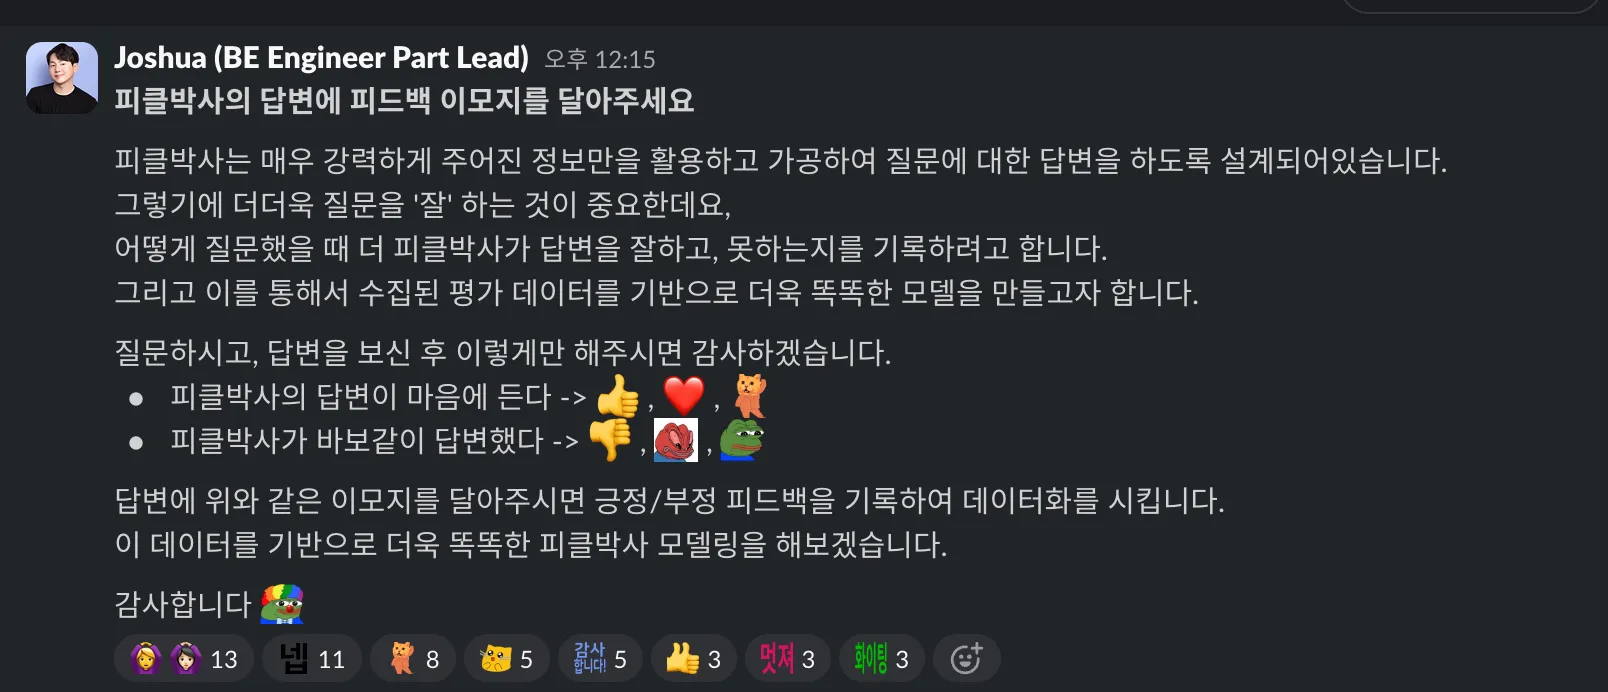
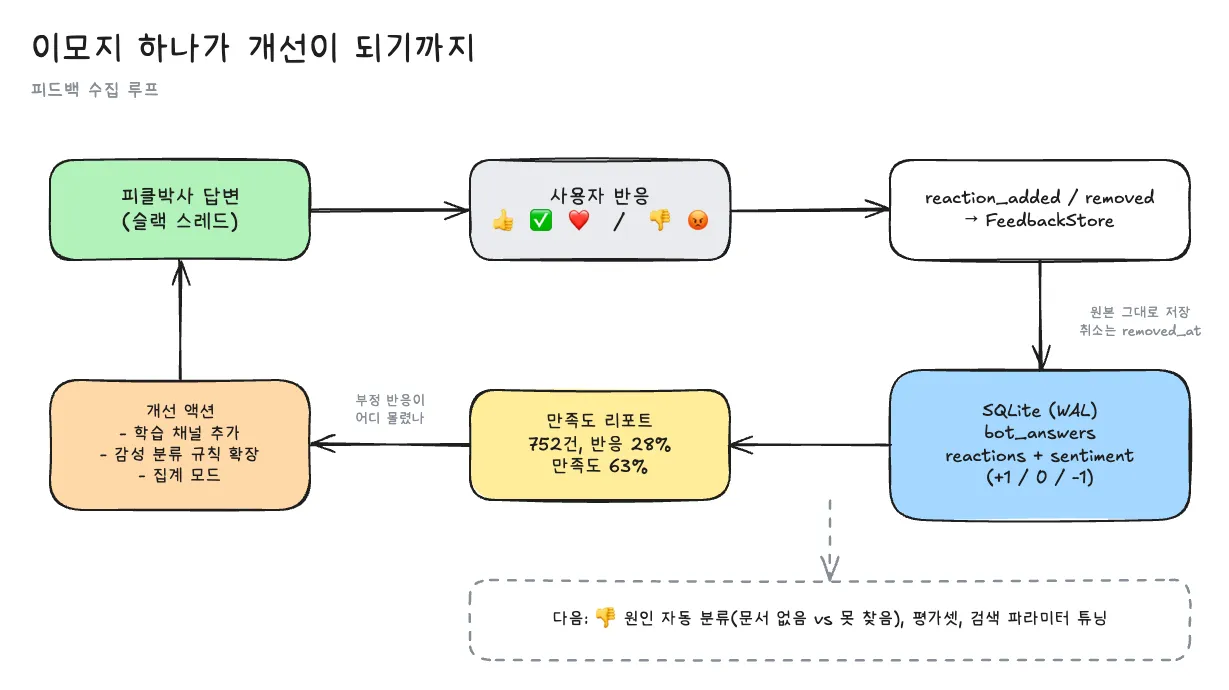
처음에는 좀 거창하게 시작했습니다.
- 질문 임베딩까지 BLOB 으로 저장하는 정식 스키마로 설계했습니다.
- 그런데 데이터를 쓰는 곳은 app 하나뿐이었습니다. 별도 DB 컨테이너까지 둘 필요가 없다고 판단해서 SQLite 파일 하나로 단순화했습니다.
테이블은 두 개입니다.
bot_answers: 질문, 답변, 출처reactions: 누가, 어떤 이모지를, 언제 달고, 언제 취소했는지
이모지는 원본 그대로 저장합니다.
- 저장하는 시점에 이모지의 의미를 해석하지 않습니다.
- 반응을 취소해도 데이터를 지우지 않고
removed_at만 기록합니다. - 나중에 해석 규칙이 바뀌어도 과거 데이터를 다시 분석할 수 있도록 하기 위해서입니다.
분석할 때마다 CASE WHEN으로 이모지를 분류하는 게 번거로워서, sentiment 컬럼(+1 / 0 / -1)을 추가했습니다.
분류 규칙이 바뀌면 앱이 시작될 때 과거 데이터까지 다시 계산합니다.
처음 두 달 동안 모은 결과
- 봇 답변: 752건
- 이모지 반응: 305건 (반응률 28%)
- 만족도 (긍정 / 명확한 긍정/부정): 63% (114 / 180)
숫자 자체보다 더 유용했던 건 부정 반응이 어디에 몰려 있는지였습니다. 부정 반응은 휴대폰 사업 용어와 CX 정책의 예외 케이스(재매칭, 해산, 환불)에 집중되어 있었습니다.
확인해보니 피클박사가 틀린 게 아니라, 해당 내용을 학습한 적이 없었습니다. 그래서 해당 팀의 질문 채널을 학습 대상에 추가했습니다.
수집 로직의 문제도 발견했습니다. 👍🏻이나 ✅ 처럼 명백히 긍정적인 반응이 중립으로 분류되고 있었습니다. 분류 규칙을 보완했습니다.
이렇게 피드백을 모으면서 문제를 진단하고, 보완할 부분을 찾을 수 있었습니다.
☁️ 10. 로컬에서 클라우드 서버로!
피클박사는 꽤 오랜 기간 제 맥북 위에서 돌고 있었습니다. 이제 AWS 클라우드 서버로 옮길 때가 됐습니다.
EC2 + docker compose
처음에는 ECS Fargate로 계획했고, 태스크 정의까지 미리 만들어두었습니다. 그런데 실제로 올리려고 보니 이 구성은 과했습니다. 가장 큰 이유는 4장에서 선택한 Socket Mode였습니다.
- 봇이 슬랙으로 먼저 연결하기 때문에, 외부에서 서버로 들어오는 요청이 하나도 없습니다.
- 그래서 로드밸런서, 도메인, HTTPS 인증서가 모두 필요 없습니다.
- 사내 봇이라 오토스케일링이 필요한 트래픽도 아닙니다.
그래서 EC2 한 대(t3.xlarge, Ubuntu) + docker compose로 결정했습니다.
로컬 구성을 거의 그대로 옮길 수 있었고, 배포 워크플로우 하나로 정리했습니다. 현재 규모에서는 EC2 한 대로 충분하다고 판단했습니다.
90분 동안 만든 임베딩, 다시 만들지 않기
맥북에서 90분 동안 CPU를 갈아 넣어 만든 임베딩을, 서버에서 처음부터 다시 만들고 싶지는 않았습니다.
ChromaDB 는 내부적으로 SQLite + hnswlib 파일로 데이터를 저장하기 때문에, 볼륨을 그대로 옮기면 될 것 같았습니다.
로컬 chroma_data 볼륨 (1.3G) → tar (714M) → S3 → EC2 에서 같은 이름의 볼륨으로 복원다행히 실제로 잘 동작했습니다. 다만 두 가지는 꼭 지켜야 했습니다.
- ChromaDB 버전을 고정해야 합니다.
저장 포맷이 버전마다 다를 수 있기 때문에0.5.23으로 고정했습니다. - 볼륨 이름을 똑같이 맞춰야 합니다.
compose 프로젝트 이름이 다르면 빈 볼륨이 새로 생성됩니다. 복원은 했는데 데이터가 없는 것처럼 보이니 주의해야 합니다.
클라우드에서 임베딩을 처음부터 하면 시간도 오래 걸리고, 필요한 서버 스펙도 꽤 높습니다. 처음에 많은 문서를 임베딩해야 한다면, 로컬에서 진행한 뒤 파일을 클라우드로 옮기는 걸 추천합니다.
SSH 키 대신 SSM, 장기 키 대신 OIDC
보안 측면에서 두 가지를 결정했습니다.
서버 접속 : SSM Session Manager
- EC2 안의 에이전트가 AWS로 먼저 연결하고, 그 채널을 통해 터미널을 엽니다. Socket Mode와 같은 원리입니다.
- 그래서 이 서버는 인바운드 포트가 하나도 없고, SSH 키도 쓰지 않습니다.
- 접근 권한은 IAM으로만 관리합니다.
배포 인증 : GitHub OIDC
- AWS access key를 GitHub Secret에 저장하는 대신, GitHub Actions가 “이 레포의 main 브랜치에서 실행 중”이라는 토큰을 제시하면 AWS가 임시 자격 증명을 발급합니다.
- 장기 키를 어디에도 저장하지 않습니다.
배포 파이프라인
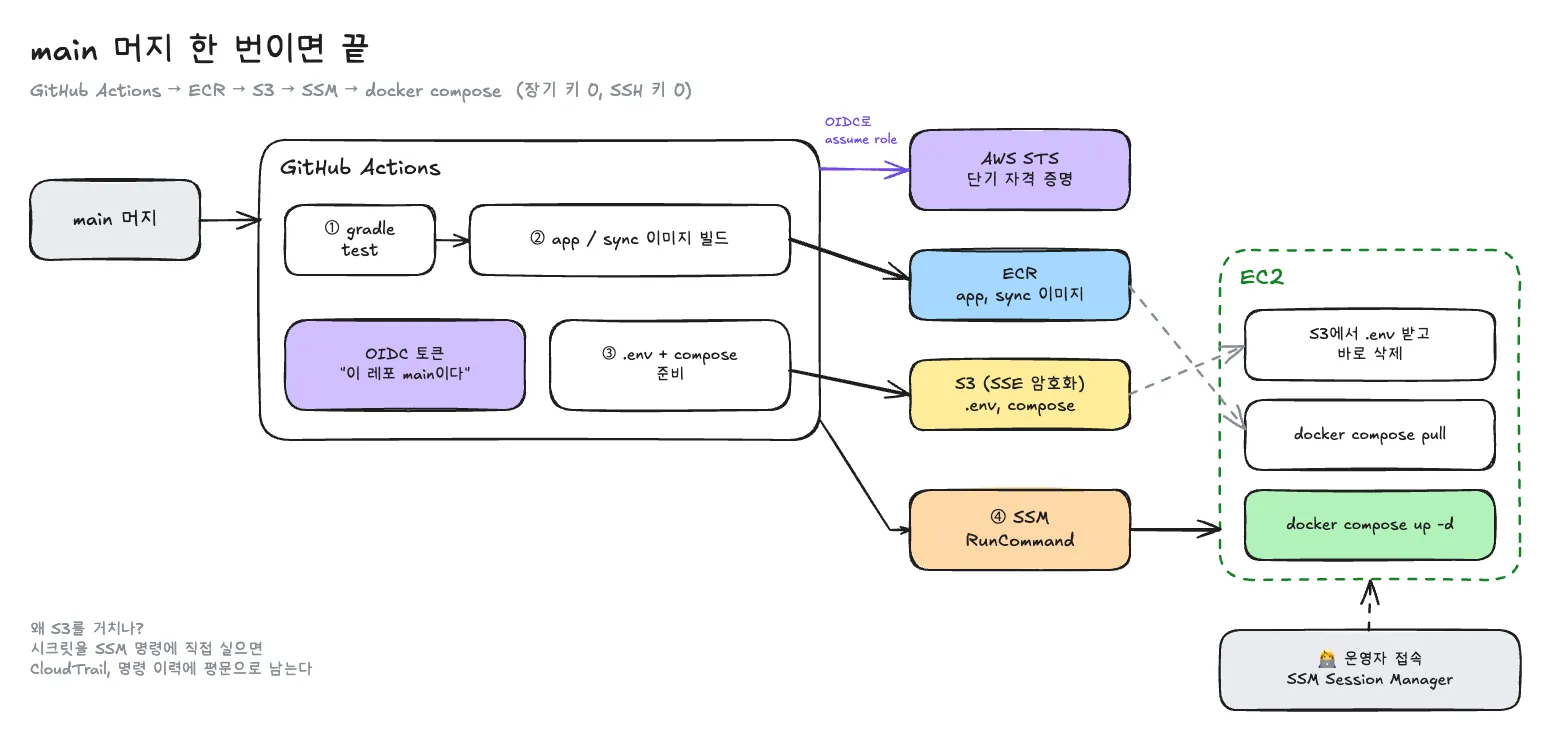
CodeDeploy나 CodePipeline은 사용하지 않았습니다.
**GitHub Actions(빌드) → ECR(이미지) → SSM(원격 실행) → docker compose(실행)**로 단순하게 구성했습니다.
🚨 11. 대형 페이지 하나가 동기화를 멈추다
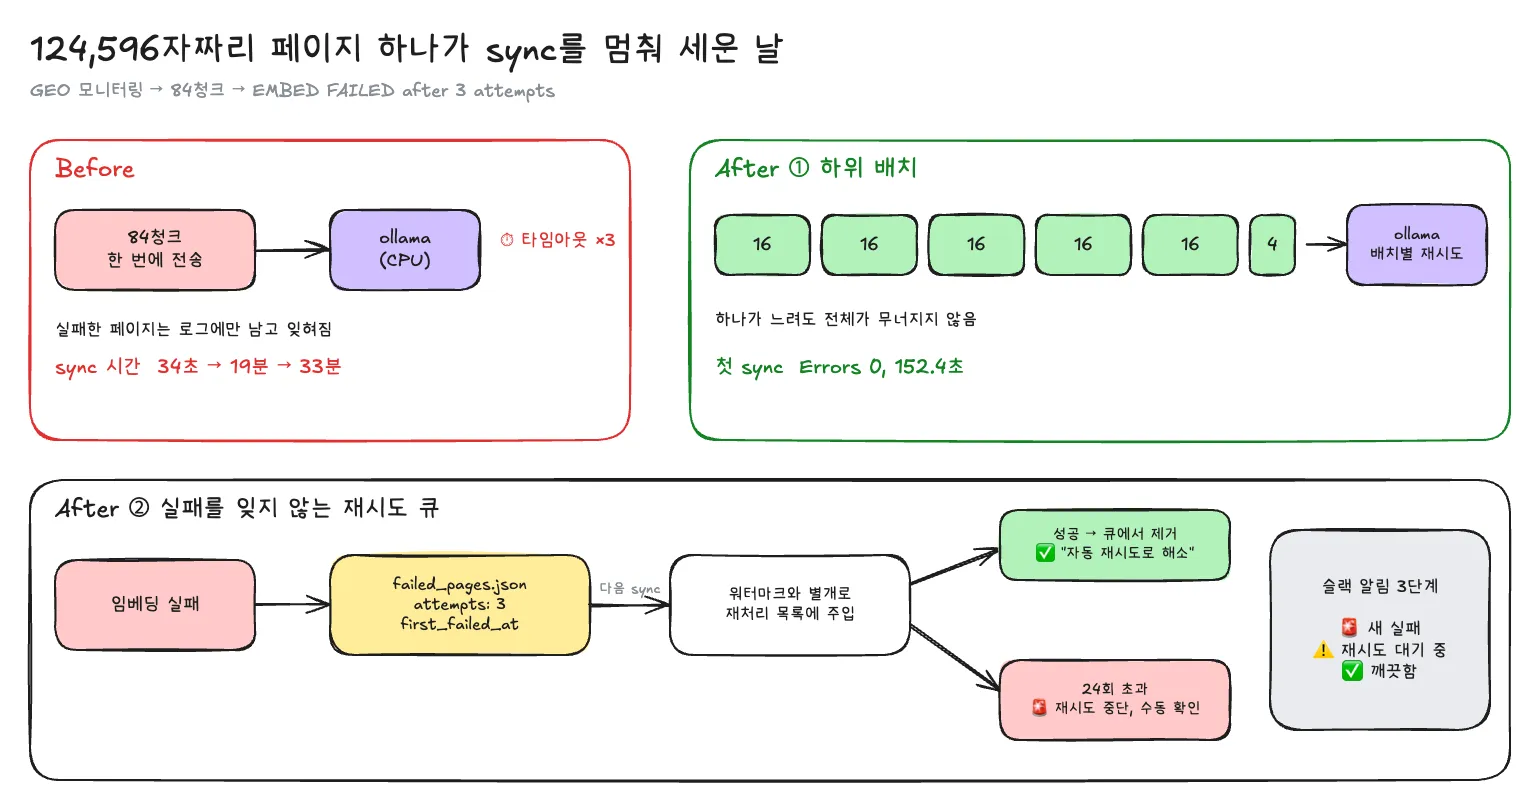
증상
- 2분이면 끝나던 동기화가 34초 → 19분 → 33분으로 점점 늘어났습니다.
- 그리고 매번
EMBED FAILED after 3 attempts로 실패했습니다.
원인
- 원인은 큰 페이지 하나였습니다. 본문이 124,596자, 청크로 나누면 84개였습니다.
- sync는 한 페이지의 청크를 한 번에 Ollama로 보내는데, CPU로 동작하는 bge-m3가 84개를 한 번에 처리하다가 타임아웃이 발생했습니다.
- 3번 재시도하고 실패, 다음 실행에서 같은 페이지를 다시 시도하고 또 실패했습니다.
해결 1. 하위 배치로 나누기
- 84개를 한 번에 보내지 않고 16개씩 나눠서 보냅니다. (16개씩 다섯 번, 마지막에 4개)
- 배치마다 따로 재시도하기 때문에, 하나가 느려도 전체가 실패하지 않습니다.
해결 2. 실패한 페이지를 기억하기
- 이전에는 실패한 페이지가 로그에만 남았습니다.
- 다음 동기화는 워터마크 이후의 변경분만 보기 때문에, 그 페이지가 다시 수정되기 전까지는 학습되지 않았습니다.
- 이제는 실패한 페이지를
failed_pages.json에 기록해두고, 다음 동기화에서 자동으로 재시도합니다. - 재시도 횟수가 24번(업무 시간 기준 약 이틀)을 넘으면 자동 재시도를 멈추고, 수동 확인이 필요하다고 알립니다.
해결 3. 알림 개선
- 이전에는 성공/실패 두 가지만 알렸습니다.
- 이제는 🚨 새로운 실패 / ⚠️ 재시도 대기 중 / ✅ 정상, 세 단계로 알립니다.
TimeoutError같은 예외 이름 대신 “임베딩 타임아웃 (대형 문서 → 하위 배치 재처리 대상)“처럼 어떤 상황인지 바로 알 수 있게 바꿨습니다.
수정 후 33분 걸리던 작업이 2분 30초로 줄었습니다. 🎉
💰 12. 그래서 얼마가 드나요?
동료: 그거 돈 많이 들지 않아요?
나: 음... 한 달에 치킨 한 마리 정도요?
동료: ...진짜요?
진짜입니다. 피클박사가 한 달 동안 쓰는. Claude API 비용은 약 $7~19, 원화로 1~3만 원 정도입니다.
- Claude API (답변, Sonnet)
- 월 비용: 약 $7~19
- 비고: 월 350
480건 × 질문당 $0.020.04
- Claude API (의도 추출, 집계 판별, Haiku)
- 월 비용: 거의 0
- 비고: 짧은 프롬프트, 캐시 적용
- 임베딩 (Ollama bge-m3)
- 월 비용: $0
- 비고: 서버에서 직접 실행
- 벡터 검색 (ChromaDB) / 키워드 검색 (Lucene)
- 월 비용: $0
- 비고: 서버에서 직접 실행
- EC2 t3.xlarge 한 대
- 월 비용: 약 $150
- 비고: 서울 리전 온디맨드 기준
(물론 서버비는 별도입니다…)
임베딩, 벡터 검색, 키워드 검색은 전부 그 서버 안에서 돌기 때문에 추가 비용이 없습니다.
질문 비용 대폭 줄이기
1장의 첫 번째 방식, 문서를 통째로 Claude에게 넘기던 방식을 기억하시나요? 그 방식 그대로 지금까지의 질문 1,198개를 받았다면 이렇게 됩니다.
- 처음 방식 (전체 컨텍스트): 1,198건 × $0.72 = 약 $862
- 지금 방식 (RAG): 1,198건 × $0.02
0.04 = 약 $2448
같은 봇, 같은 질문인데 비용은 20분의 1 수준입니다. 이렇게 낮출 수 있었던 이유는 세 가지입니다.
- 임베딩을 직접 띄웠습니다. 문서를 넣을 때도, 질문할 때도 임베딩 비용이 0입니다.
- 비싼 모델은 한 군데에만 씁니다. 답변 작성만 Sonnet이 하고, 의도 추출, 분류, map 같은 보조 작업은 전부 Haiku가 합니다.
- Claude 에게 보내는 양을 계속 줄였습니다. RAG, 유사도 필터링, prompt caching으로 질문당 $0.72 에서 몇 센트까지 내려왔습니다.
그래서 효과는요?
서버로 옮긴 6월 4일부터 지금까지, 동료 32명이 피클박사에게 1,198번 질문하고 답변을 받았습니다. 질문 기록은 서버로 옮기면서부터 쌓기 시작해서, 맥북 시절의 질문은 이 숫자에 들어 있지 않습니다. 실제로는 이보다 훨씬 많을 거예요.
숫자보다 더 기뻤던 건 이 장면이었습니다. CX팀이 업무 질문 채널을 새로 만들면서, 질문하는 방법을 이렇게 공지했습니다.
피클박사에게 먼저 물어보는 것이 팀의 업무 프로세스에 들어간 것입니다.
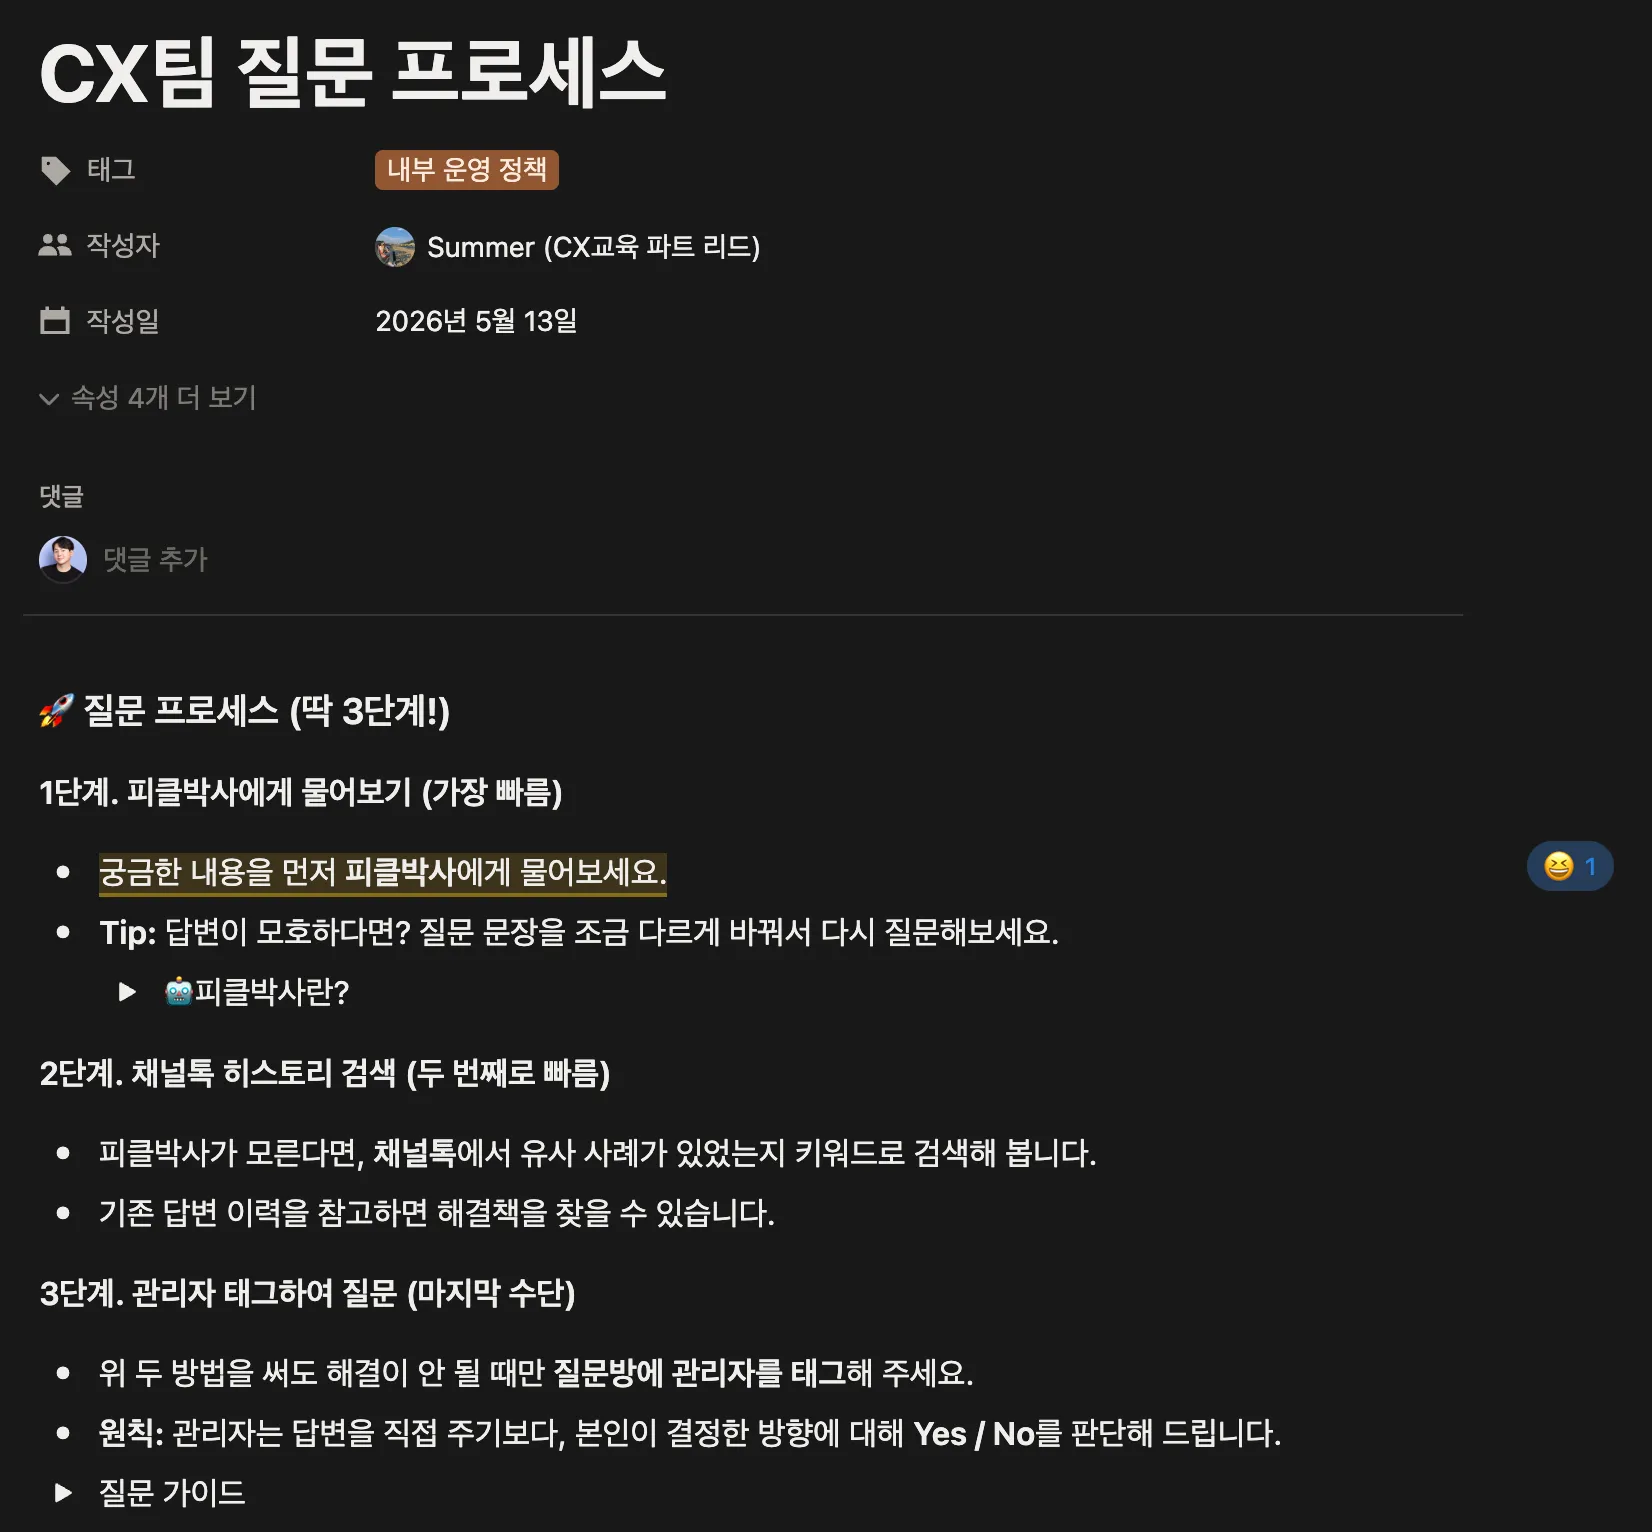
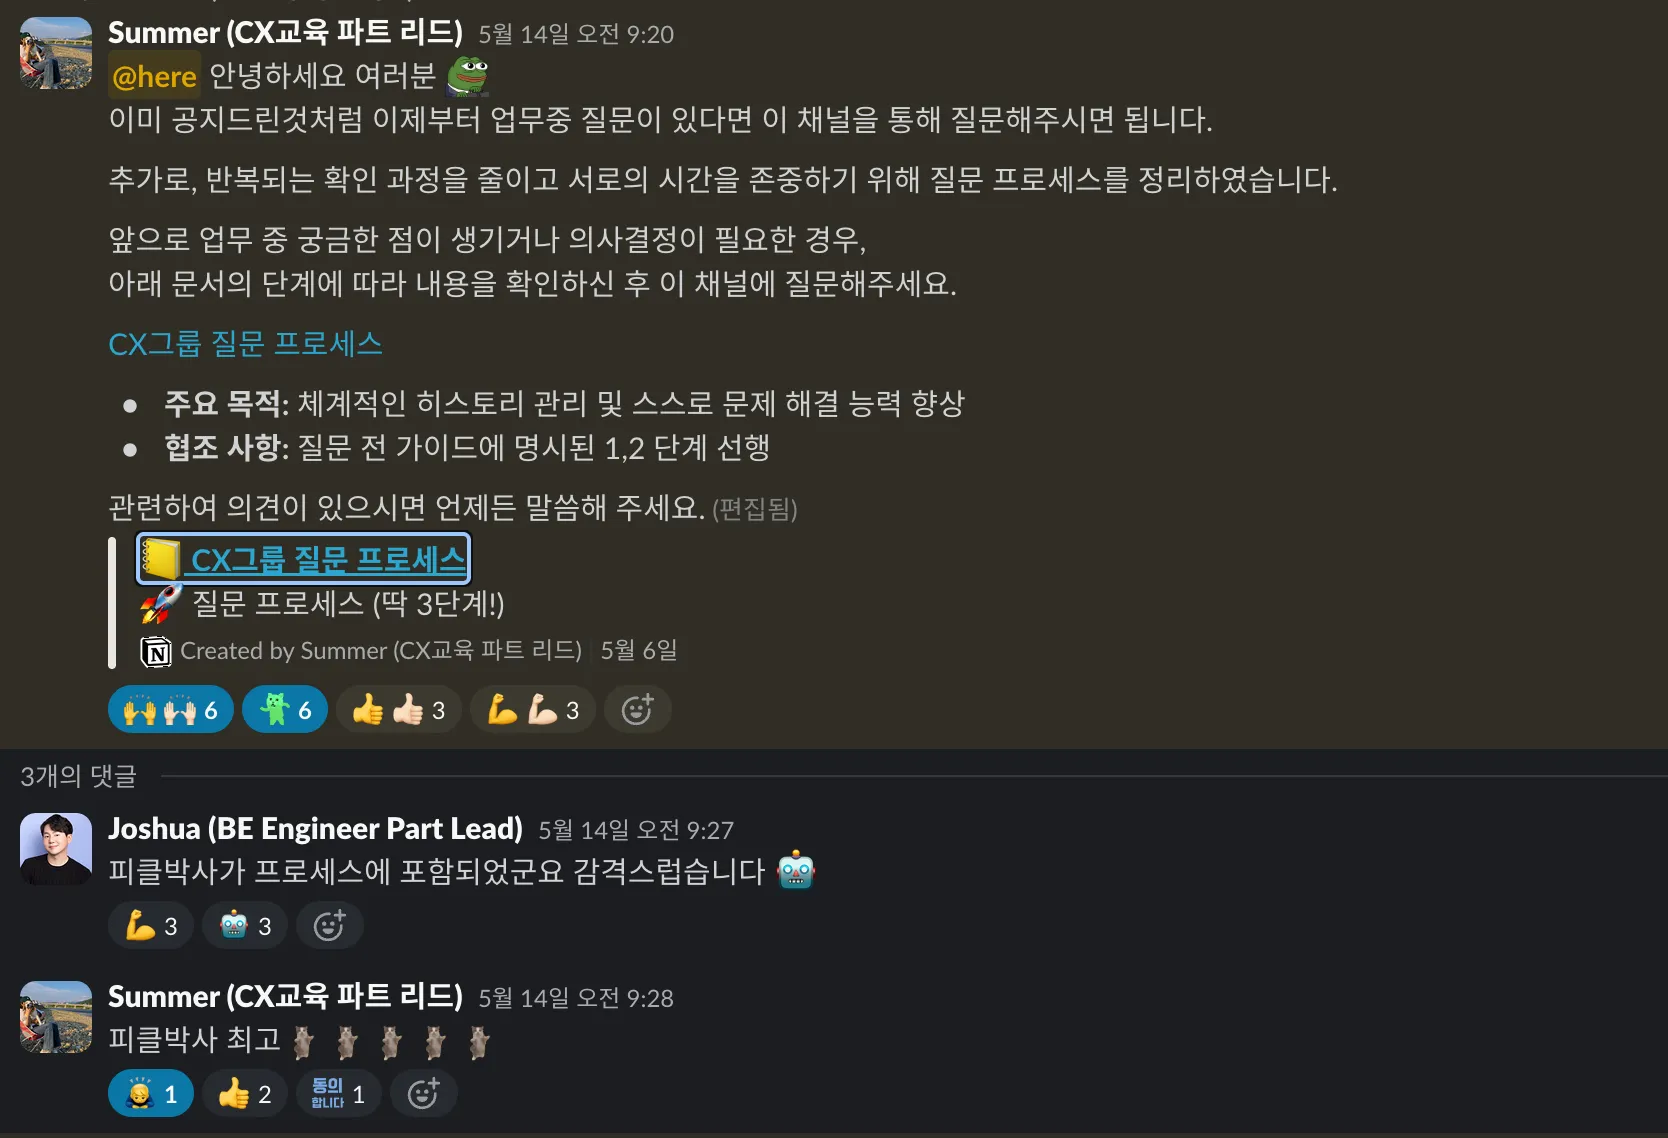
만든 사람 입장에서 이것보다 큰 칭찬은 없는 것 같습니다. 🥹
200시간을 몇만 원에 사다
질문 하나에 묻는 사람과 답하는 사람이 5분씩만 아꼈다고 쳐보겠습니다.
1,198건 × 10분 = 11,980분 = 약 200시간하루 8시간으로 나누면 25일, 한 사람이 한 달 넘게 일해야 하는 시간입니다. 그 시간을 Claude API 값 $24~48로 산 셈입니다.
💡 얻은 것
사내 AI 봇의 비용은 어떤 모델을 쓰느냐보다, 모델에게 무엇을 얼마나 잘 학습시키느냐에서 결정됩니다.
서버 한 대 값만 감당할 수 있다면, 나머지는 매우 저렴하게 큰 효과를 누릴 수 있습니다. (PoC라면 첫 피클박사처럼 로컬 머신에서 돌려보는 것도 좋은 방법입니다.)
🧰 13. 사내 RAG 봇을 만든다면 체크해볼 것들
직접 만들어보실 분들을 위해, 위에서 겪은 것들을 체크리스트로 정리했습니다.
설계
- 슬랙 봇이라면 Socket Mode로 시작하세요. 공개 엔드포인트가 필요 없어서 개발도, 인프라도, 보안도 단순해집니다.
- 무거운 동기화 작업과 항상 떠 있어야 하는 봇은 프로세스를 분리하세요.
- 프롬프트에는 “문서에 없으면 모른다고 말하라”를 꼭 넣으세요. 사내 정책을 다루는 봇에게 할루시네이션은 치명적입니다.
검색
- 한국어라면 임베딩 모델부터 한국어로 테스트하세요. nomic에서 bge-m3로 바꾼 것만으로 검색 품질이 완전히 달라졌습니다.
- 벡터 검색만으로는 고유명사가 약합니다. BM25를 같이 돌리고 RRF로 합치면 점수 스케일 걱정 없이 섞을 수 있습니다.
- 코퍼스가 커지면 유사도 거리 컷, 페이지당 청크 제한, 최신 문서 가산점을 다시 조정하세요.
- “전부 정리해줘” 같은 집계 질문은 RAG 로 안 됩니다. **별도 경로(메타데이터 전수 조회 + map-reduce)**를 두는 게 좋습니다.
데이터
- 외부 서비스의
last_edited_time같은 변경 감지 신호는 실제 API 로 확인하세요. 노션은 하위 DB가 바뀌어도 부모 페이지의 변경 시각을 변경하지 않습니다. - 실패한 동기화 대상은 재시도 큐에 남겨두세요. 증분 동기화는 한 번 놓친 걸 다시 보지 않습니다.
- 슬랙 데이터는 학습할 때와 내보낼 때, 두 번 걸러내세요. (멘션, 개인정보 등)
운영
- 답변에 달리는 이모지 반응을 저장해두세요. 이 피드백이 답변 품질을 높이는 출발점이 됩니다.
- 모델 ID는 설정 파일로 빼두세요. 날짜가 붙은 모델은 언젠가 바뀌거나 없어질 수 있습니다.
🚀 14. 앞으로 하고 싶은 것
현재 피클박사는 노션의 이미지 블록을 학습하지 않습니다. 그런데 사내 지식의 꽤 많은 부분이 스크린샷, 표 캡처, 다이어그램 같은 이미지에 담겨 있습니다. 다음 목표는 두 가지입니다.
1. 이미지를 읽는 피클박사
- 노션 이미지 블록과 슬랙 첨부 이미지를 Claude 비전으로 분석해 텍스트로 바꾸고, 기존 동기화 파이프라인에서 함께 학습하도록 할 계획입니다.
2. 피드백으로 개선되는 피클박사
- 지금은 이모지 반응을 수집만 하고 있습니다.
- 수집한 데이터를 평가셋으로 만들고, 👎가 달린 답변이 “문서가 없어서”인지 “문서는 있는데 찾지 못해서”인지 자동으로 분류하려고 합니다.
- 그 결과를 바탕으로 검색 파라미터를 조정하는 흐름까지 만들어볼 예정입니다.
그 밖에도 Socket Mode 웹소켓 구현체 교체, 배포 CI 대기 로직 수정, ChromaDB 정기 백업, Asana나 BigQuery 같은 다른 데이터 소스 연동이 남아 있습니다. 잘 동작하게 되면 후속 글로 다시 찾아오겠습니다.
🙏🏻 15. 글을 마치며
피클박사는 입사한 지 얼마 안 됐을 때, “이거 어디서 확인해요?“를 덜 물어보고 싶어서 혼자 시작한 개인 프로젝트였습니다. 맥북 한 대에서 제 개인 API 키로 돌던 봇이, 이제는 서버 위에서 24시간 돌면서 동료 32명이 1,198번 찾는 사내 도구가 됐습니다.
💡 이번 프로젝트를 통해 얻은 것
- RAG는 만능이 아닙니다. 질문의 성격이 다르면 처리 경로도 달라야 했습니다. (feat. MBTI 사건)
- 외부 서비스의 동작은 문서가 아니라 실제 응답으로 확인해야 합니다.
- 인프라는 지금 문제의 크기에 맞게 고르면 됩니다.
- 개선은 측정에서 시작됩니다.
- 좋은 모델보다 좋은 구조가 비용을 줄입니다. 서버 한 대만 있으면, API 비용은 한 달 치킨 한 마리 값으로도 충분했습니다.
피클플러스에서 함께할 개발자를 찾고 있습니다
피클박사를 만들면서 가장 크게 느낀 건, 저희 회사에는 풀어볼 만한 문제가 정말 많다는 점이었습니다. 외부 정책이 바뀌면 저희 정책도 같이 바뀌고, 그 변화가 노션과 슬랙과 코드에 반영되고 관리되어야 합니다.
그리고 피클플러스는 입사 몇 주 차 개발자가 혼자 시작한 사이드 프로젝트를, 전사 도구가 될 때까지 믿고 맡겨주는 곳이기도 합니다.
- 문제가 보이면 일단 만들어보는 걸 좋아하시는 분
- 복잡한 도메인을 정리해서 단순한 구조로 바꾸는 데 재미를 느끼시는 분
- 만든 것이 실제로 쓰이는 걸 보는 게 가장 큰 보람이신 분
이런 분이라면 피클플러스와 잘 맞으실 겁니다.
김민재
Joshua백엔드 파트 리드
피클에서 세계정복